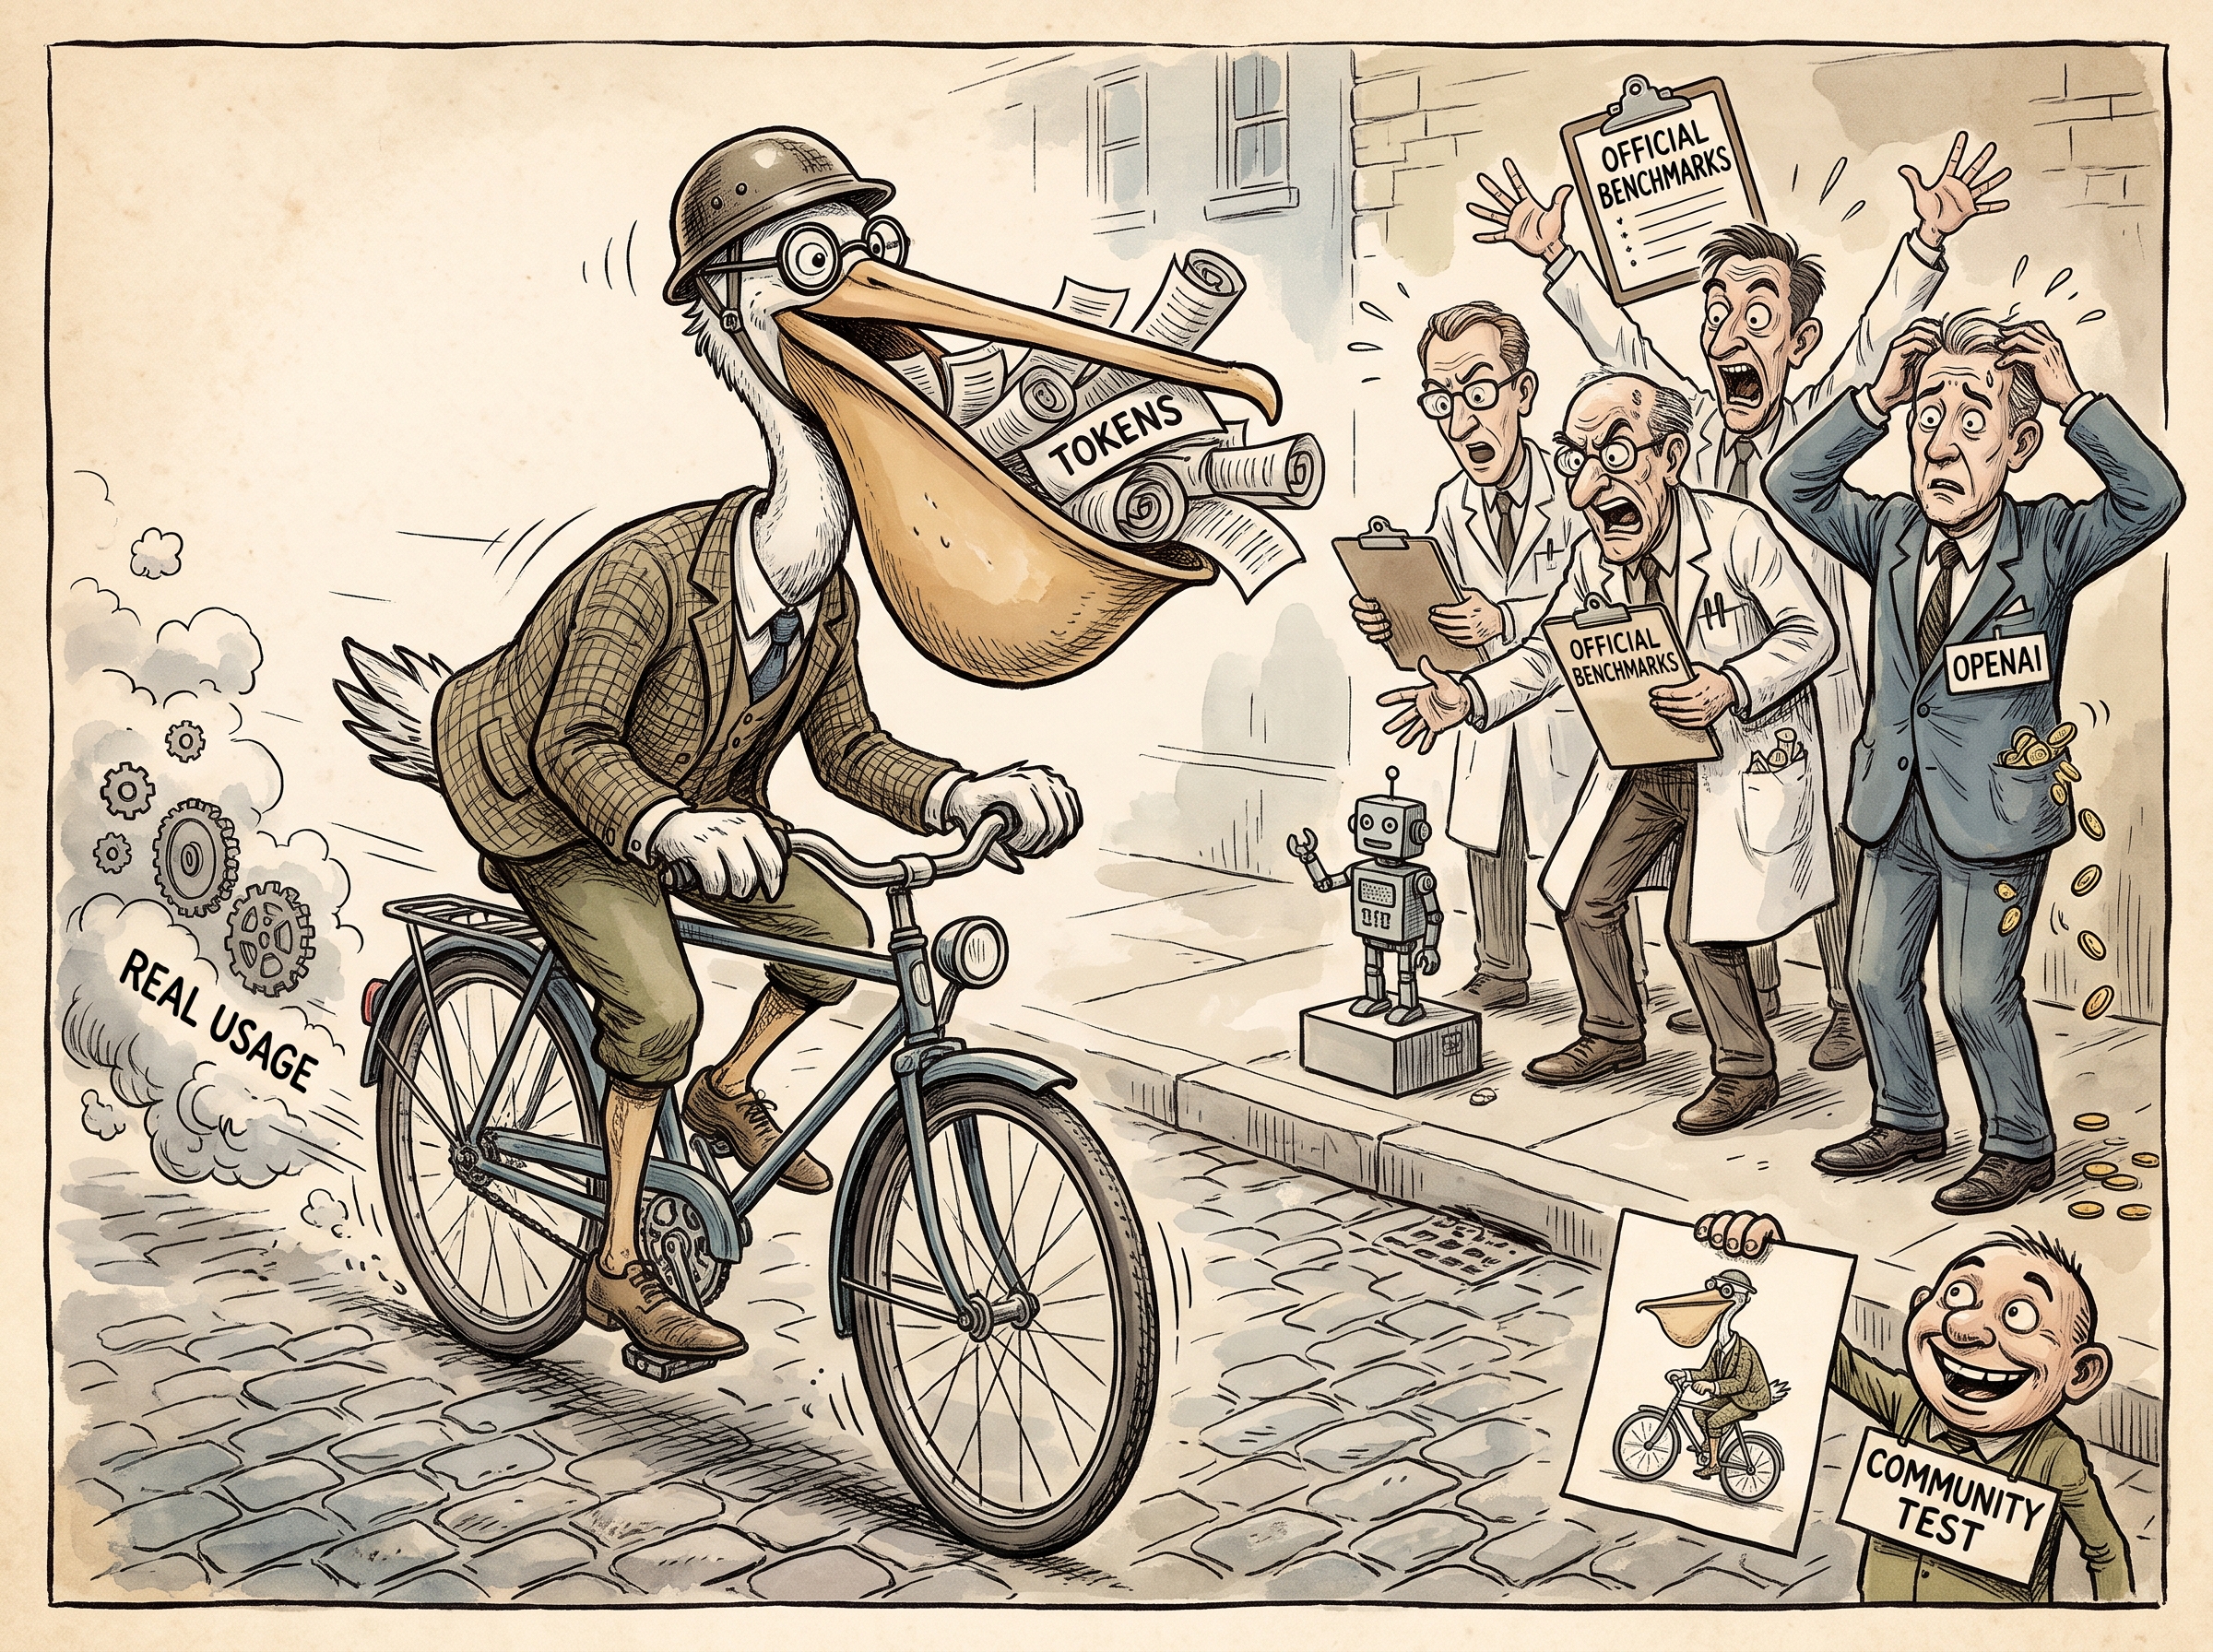
Саймон Уиллисон — один из самых наблюдательных комментаторов индустрии ИИ-инструментов для разработки — обратил внимание на утечку внутренней статистики OpenAI: там видно, как сотрудники компании используют собственные кодовые агенты, и в середине июля расходы на токены резко подскочили. Уиллисон предполагает, что скачок совпал с моментом, когда внутренний инструмент под названием Astra стал доступен рядовым сотрудникам. Отдельным твитом он же обратил внимание сообщества на то, как Astra справляется с его фирменным тестом «пеликан на велосипеде». Два коротких сообщения, а за ними — интересный срез того, как сейчас в индустрии измеряют пользу от ИИ-агентов и их качество.
Всплеск токенов как индикатор реального внедрения
Метрики расхода токенов внутри компании — куда честнее любых пресс-релизов. Если инструмент для написания кода становится доступен сотрудникам и потребление токенов резко растёт, это значит, что люди действительно начали им пользоваться в рабочих задачах, а не просто попробовали один раз из любопытства. Именно поэтому наблюдение Уиллисона так ценно: оно косвенно подтверждает, что внутренний агент OpenAI (Astra) в какой-то момент летом перешёл из статуса эксперимента в статус рабочего инструмента для инженеров.
Для тех, кто следит за экосистемой ИИ-агентов для написания кода, это важный сигнал в целом: крупные лаборатории не только продают агентов клиентам, но и активно едят собственный корм — используют похожие инструменты внутри для своей разработки. Это ровно та же логика, по которой Anthropic использует Claude Code для работы над самим Claude Code.
Тест «пеликан на велосипеде» как барометр качества
Второй твит — ретвит теста @gabrielchua, где Astra получает классический для Уиллисона промпт: нарисовать SVG-изображение пеликана, едущего на велосипеде. Тест «пеликан на велосипеде» давно стал неформальным, но узнаваемым бенчмарком в комьюнити ИИ-разработчиков: задача достаточно абсурдная, чтобы модель не могла найти готовый ответ в обучающих данных, и достаточно наглядная, чтобы результат можно было оценить одним взглядом — без метрик, таблиц и бенчмарков с закрытыми весами.
Почему неформальные тесты вроде этого работают
У формальных бенчмарков для кодовых моделей есть известная проблема: как только тест становится популярным, его результаты начинают просачиваться в обучающие выборки, и модели показывают успехи, которые не отражают реальной способности рассуждать. Тест «пеликан на велосипеде» устроен иначе — SVG для пеликана на велосипеде почти не встречается в интернете, задача требует пространственного воображения и умения превратить абстрактную идею в конкретный код разметки. Именно поэтому такие тесты, придуманные и распространяемые сообществом, часто говорят о реальных возможностях модели больше, чем официальные отчёты вендоров.
Что это значит для тех, кто работает с Claude Code
Для читателей, которые ежедневно используют Claude Code, оба наблюдения — не просто любопытные факты о конкуренте. Рост внутреннего потребления токенов в OpenAI показывает, куда движется рынок: агенты для написания кода перестают быть нишевой фичей и становятся базовой инфраструктурой разработки, конкуренция за качество и удобство агентов будет только нарастать. А неформальные тесты вроде «пеликана на велосипеде» — удобный способ для самих разработчиков быстро прикинуть, на что способен тот или иной агент, не дожидаясь официальных бенчмарков.
Проверить, как Claude справляется с той же задачей, — минутное дело и хороший повод самому оценить, сохраняет ли Claude Code лидерство в том, что действительно важно: способности агента понимать нетривиальную задачу и доводить её до рабочего результата.
Добавить комментарий