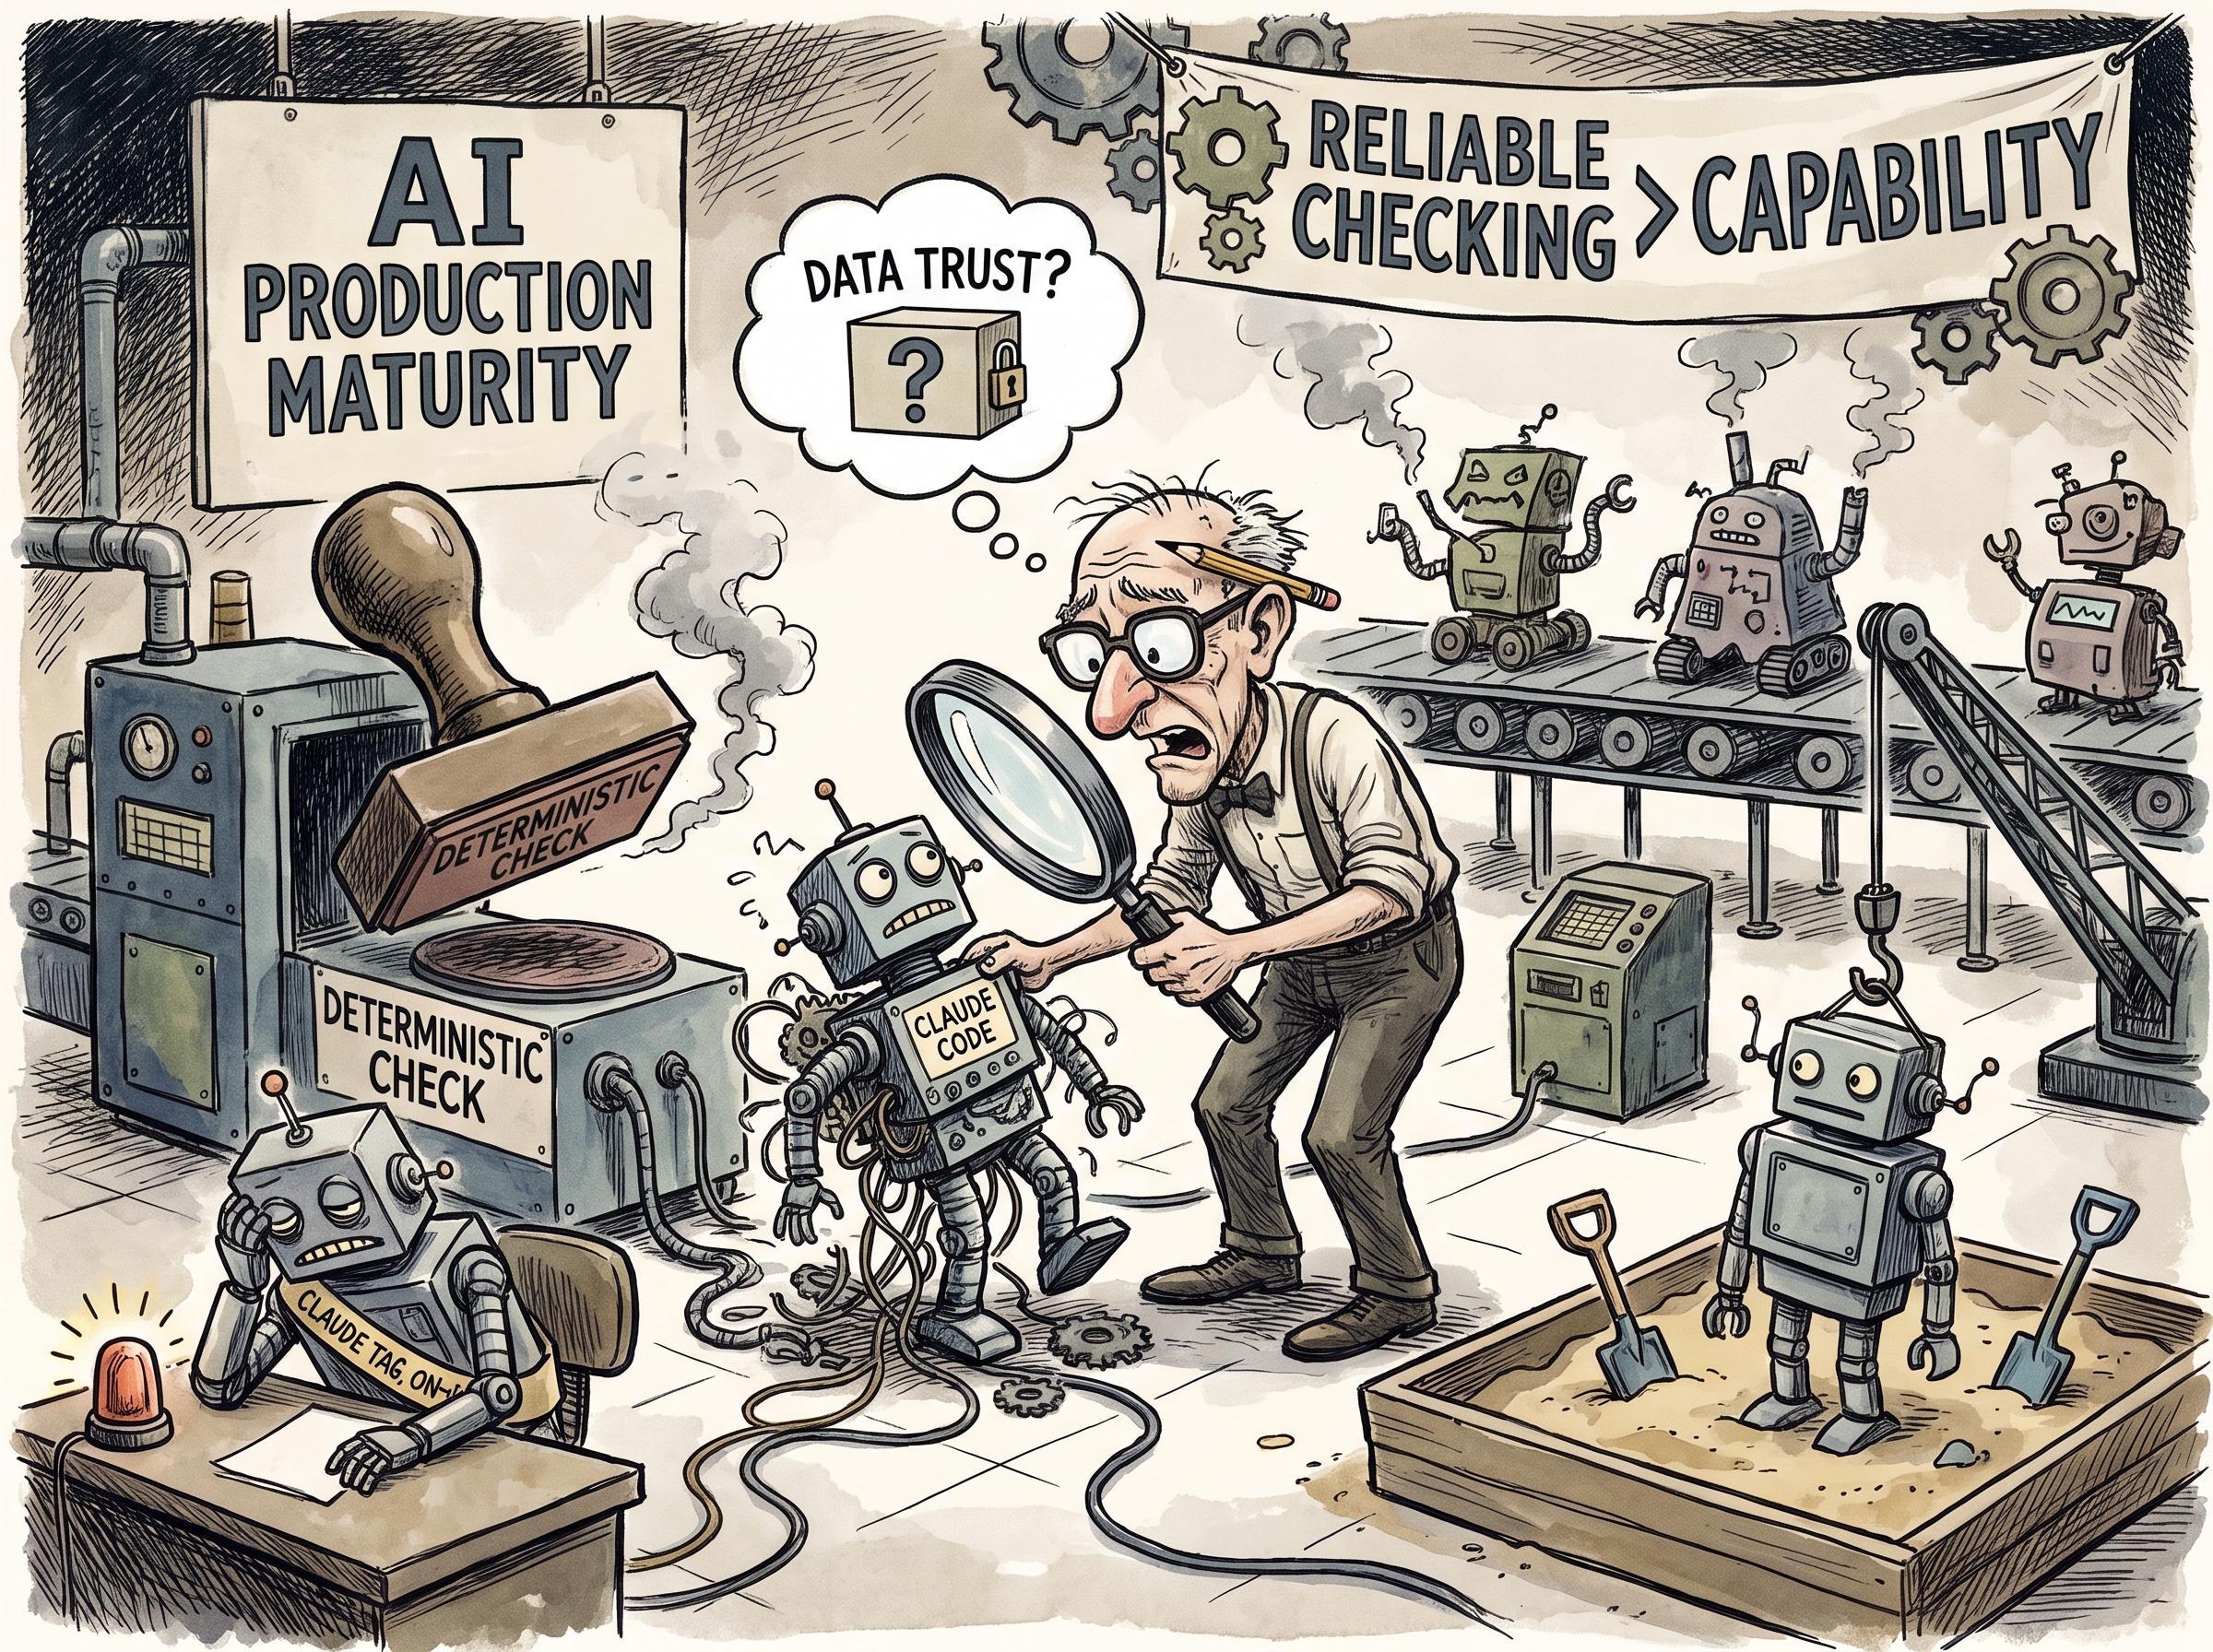
На этой неделе в X обсуждали не очередной рекорд бенчмарков, а вещи куда практичнее: как сделать так, чтобы AI-агенты в продакшене не просто работали, а работали предсказуемо. Четыре поста — от независимого разработчика Саймона Уиллисона и от команды Anthropic — на первый взгляд о разном, но на деле складываются в один сюжет: индустрия перешла от вопроса «может ли агент это сделать» к вопросу «как мы узнаем, что он сделал это правильно».
Детерминированная проверка результата агента
Уиллисон обратил внимание на формулировку, мелькнувшую в одном из новых агентных продуктов: «детерминированный код проверяет результат». По его наблюдению, это похоже на облегчённый вариант идеи из статьи DeepMind о CaMeL — подхода, где LLM генерирует план или код, а его корректность и безопасность проверяет уже не другая модель, а обычный детерминированный верификатор. Это важный сдвиг мышления. Модель хороша в порождении гипотез и черновиков, но плохой судья самой себе: она может убедительно объяснить, почему неправильный ответ правильный. Связка «агент предлагает — код проверяет» переносит момент истины из зоны вероятностного вывода в зону, где есть однозначный да/нет. Для тех, кто строит агентные пайплайны — будь то генерация текста, код-ревью или автоматизация задач, — это практический рецепт: там, где можно сформулировать проверяемый инвариант, не полагайтесь на вторую LLM в роли контролёра первой.
ИИ-агент на дежурстве: опыт Claude Tag
Команда ClaudeDevs показала, во что превращается эта философия на практике: агент по имени Tag стал первым дежурным по CI-инцидентам. Он читает алерты, метрики и логи, пишет SITREP (ситуационный отчёт) и по ходу работы пополняет файл lessons.md — по сути, накапливает институциональную память о том, какие сбои уже случались и как их диагностировали. Anthropic опубликовала шаблон и skills для повторения этой схемы у себя. Это интересно не как единичный кейс, а как шаблон применения агентов там, где раньше их боялись подпускать: в дежурстве по продакшену, где цена ложного вывода — потерянное время инженеров ночью. Ключевая деталь — не автономность агента, а его прозрачность: SITREP и растущий журнал уроков превращают чёрный ящик в артефакт, который человек может проверить постфактум.
Managed Agents: как стартапы масштабируют продукты на AI-агентах в продакшене
Второй пост ClaudeDevs — интервью с основателями Wispr Flow, Actively и Pendo — заходит с другой стороны: не «как Anthropic использует агентов внутри», а «как на них строить бизнес». Общие для всех трёх компаний темы — outcomes (агенту ставится измеримый результат, а не набор шагов), sandboxing (изоляция побочных эффектов, чтобы ошибка агента не выплеснулась в реальные системы) и память между сессиями. Это ровно те три опоры, без которых Claude Tag остался бы демо, а не рабочим инструментом: измеримая цель, безопасная среда выполнения и накопление контекста. Для разработчиков, которые сейчас проектируют собственных агентов, это готовый чек-лист вопросов к архитектуре — прежде чем спрашивать «какую модель взять», стоит спросить «как мы измерим успех агента и что случится, если он ошибётся».
Доверие и данные: что скрывается за «улучшением модели»
Отдельным сюжетом прошёл разбор Уиллисона истории вокруг заявленного OpenAI решения проблемы Навье-Стокса — он использовал повод, чтобы поднять более общий и до сих пор нерешённый вопрос: что именно компании имеют в виду под фразой «использовать ваши данные для улучшения модели». Формулировка звучит нейтрально, но охватывает и дообучение, и оценку качества, и просто хранение логов — а пользователю обычно не сообщают, какой именно вариант применяется к его данным. На фоне растущей автономности агентов это не абстрактный вопрос about privacy policy: если агент действует на основе истории взаимодействий, пользователю важно понимать, куда и как эта история утекает за пределы конкретной сессии.
Что это значит для практики
Все четыре истории — о разных гранях одной задачи: сделать AI-агентов в продакшене настолько же предсказуемыми, насколько предсказуем обычный код. Детерминированная проверка снижает риск непроверяемых решений, дежурный агент с журналом уроков делает автономность прозрачной, а фреймворк Managed Agents формализует то, без чего эта автономность просто не масштабируется. Вопрос о данных — это напоминание, что доверие к агенту начинается не с качества его ответов, а с ясности того, что происходит с информацией, которую он видит.
Добавить комментарий