YouTube-эссе
-
Взрыв интеллекта: почему выигрывает не одна модель, а мультиагентная оркестрация LLM
Читать далее →: Взрыв интеллекта: почему выигрывает не одна модель, а мультиагентная оркестрация LLMЗа несколько дней вышло больше пяти новых моделей — от Deepseek V4 до Gemini 3.7 Flash. IndyDevDan показывает на своём инструменте fusion harness, что в такой момент выигрывает не выбор «лучшей» модели, а мультиагентная оркестрация LLM: несколько моделей работают параллельно, спорят и собираются в единый план. Главный вывод — ценность не в конкретной модели, а…
-
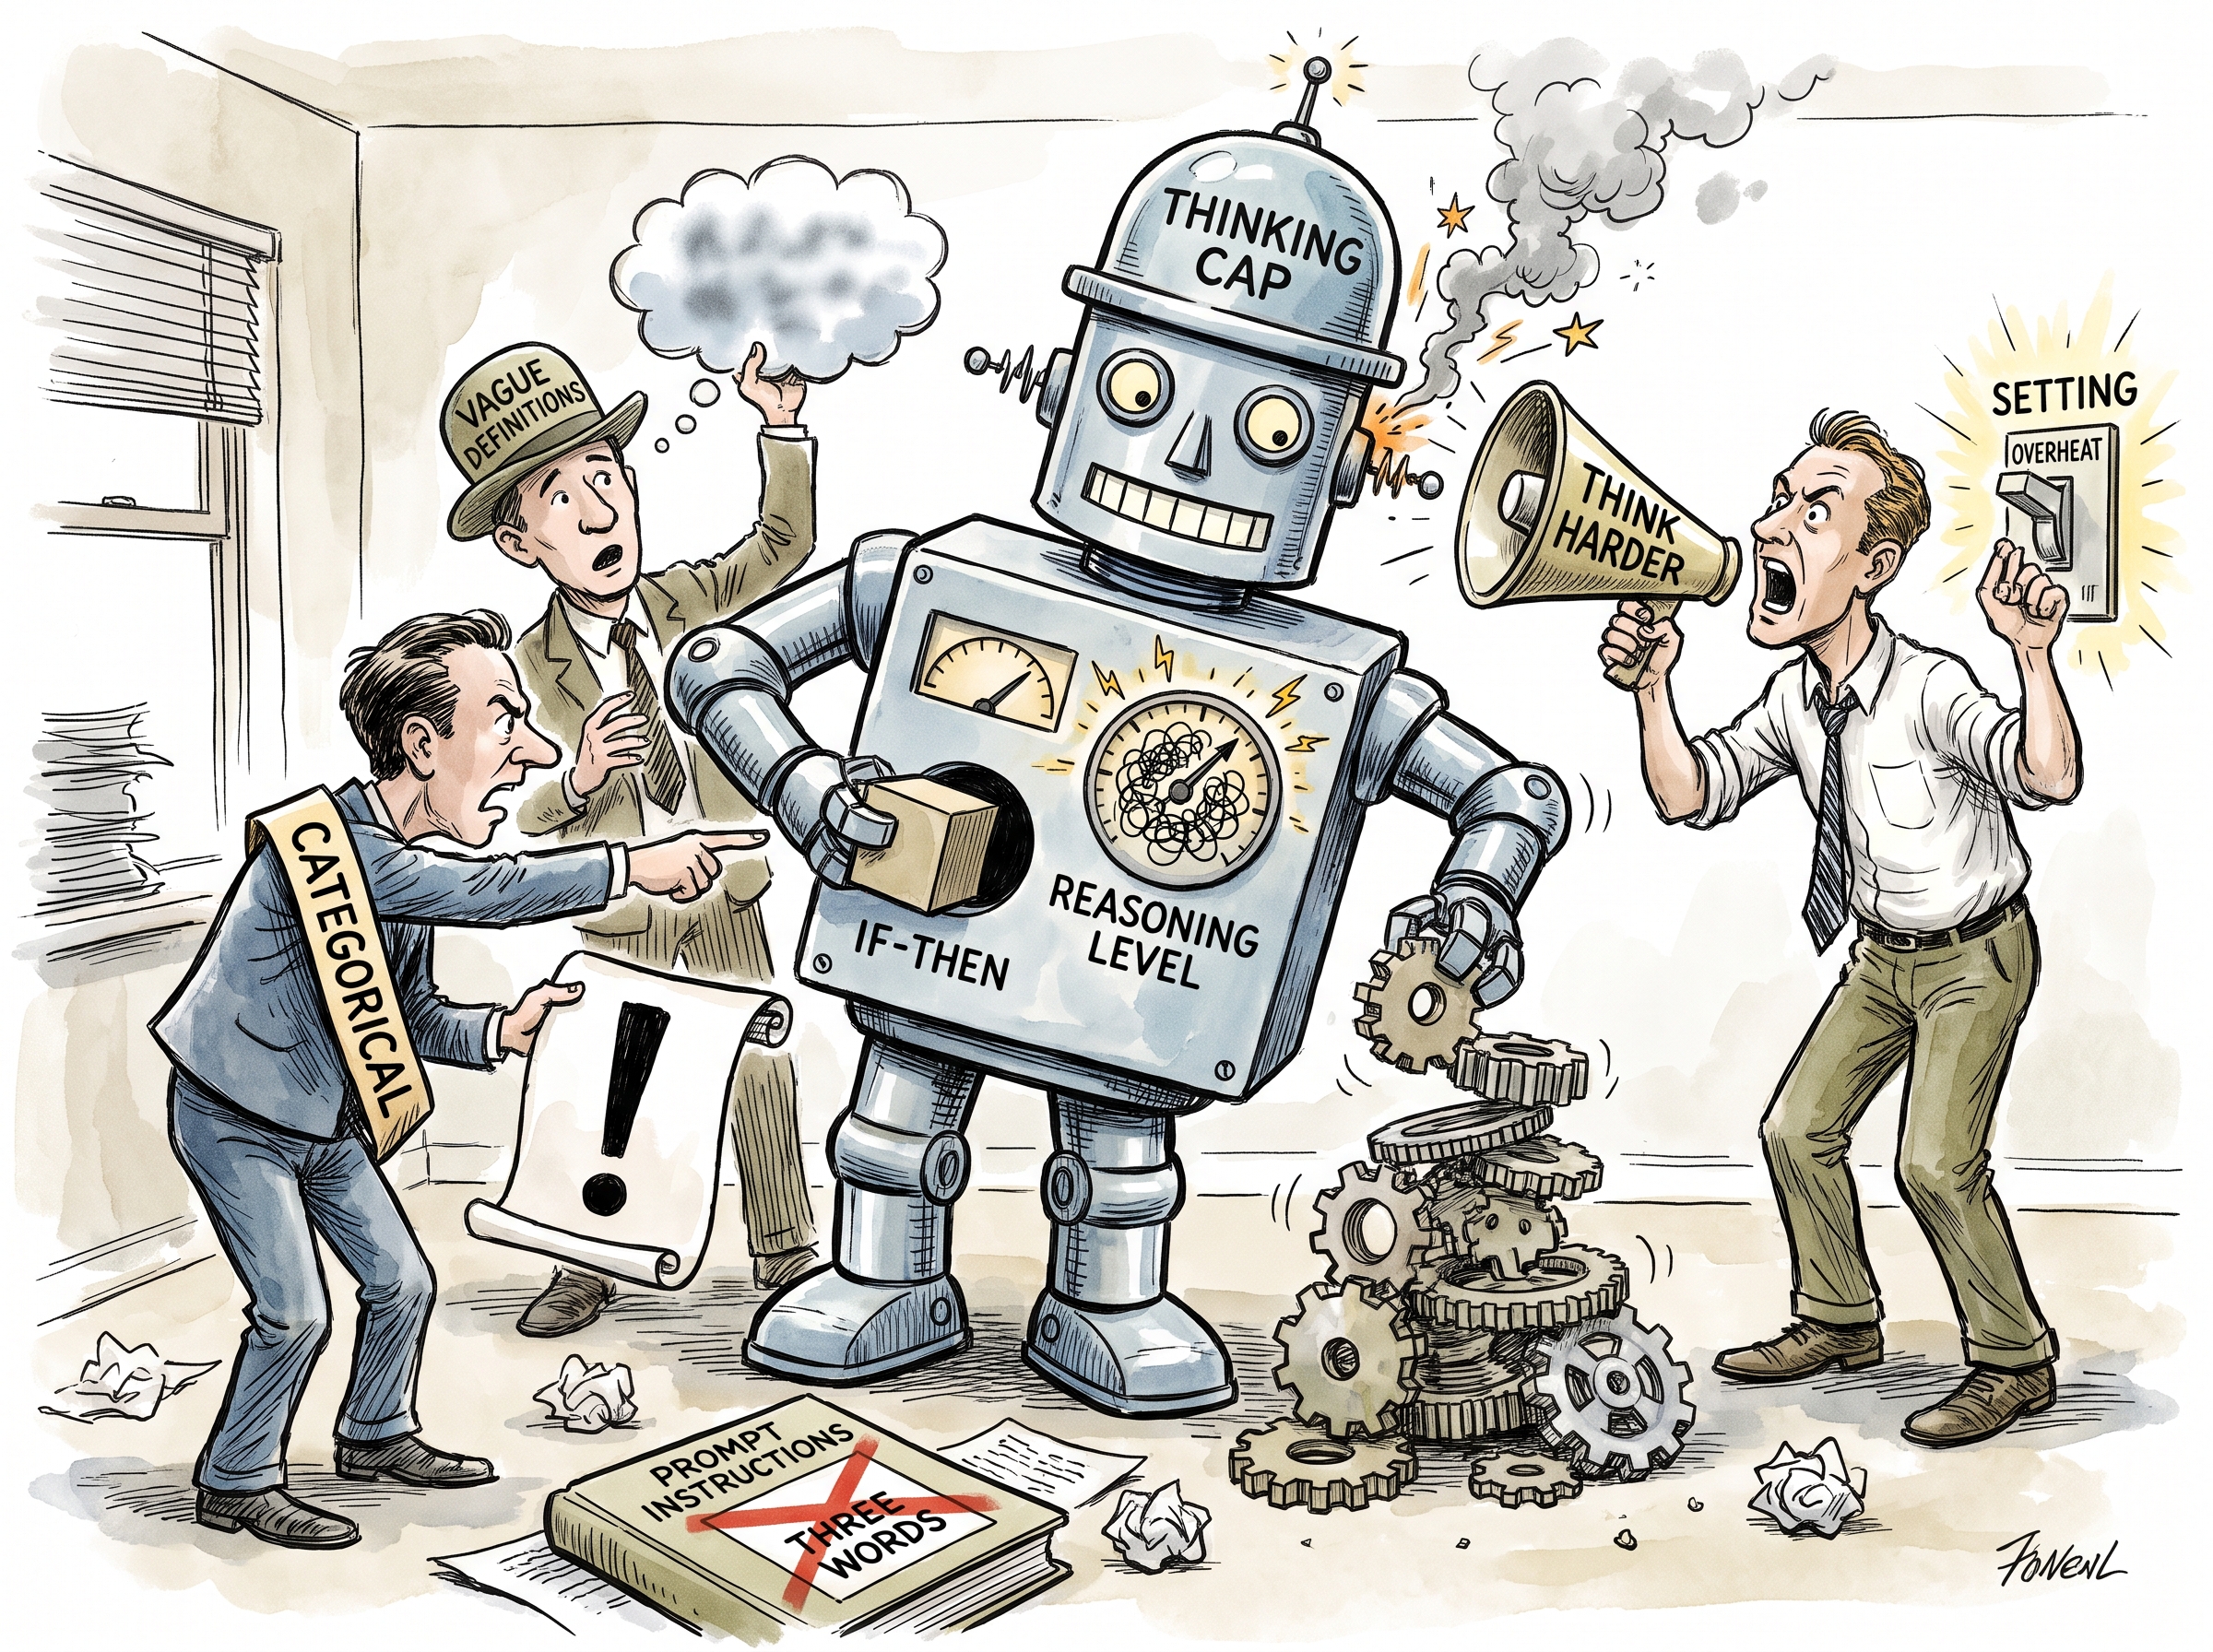
Промпты для нейросетей: три слова, которые всё портят в 2026 году
Читать далее →: Промпты для нейросетей: три слова, которые всё портят в 2026 годуАвтор канала Dylan Davis показывает, почему промпты, которые ещё недавно отлично работали, сегодня портят результат: новые модели читают инструкции слишком буквально. Проблема в трёх типах слов — категоричных требованиях, расплывчатых определениях и просьбах «думать усерднее». Решение — заменить их на if-then-условия, точные критерии или примеры, а «усердие» переключать настройкой уровня рассуждений в самом инструменте, а…
-
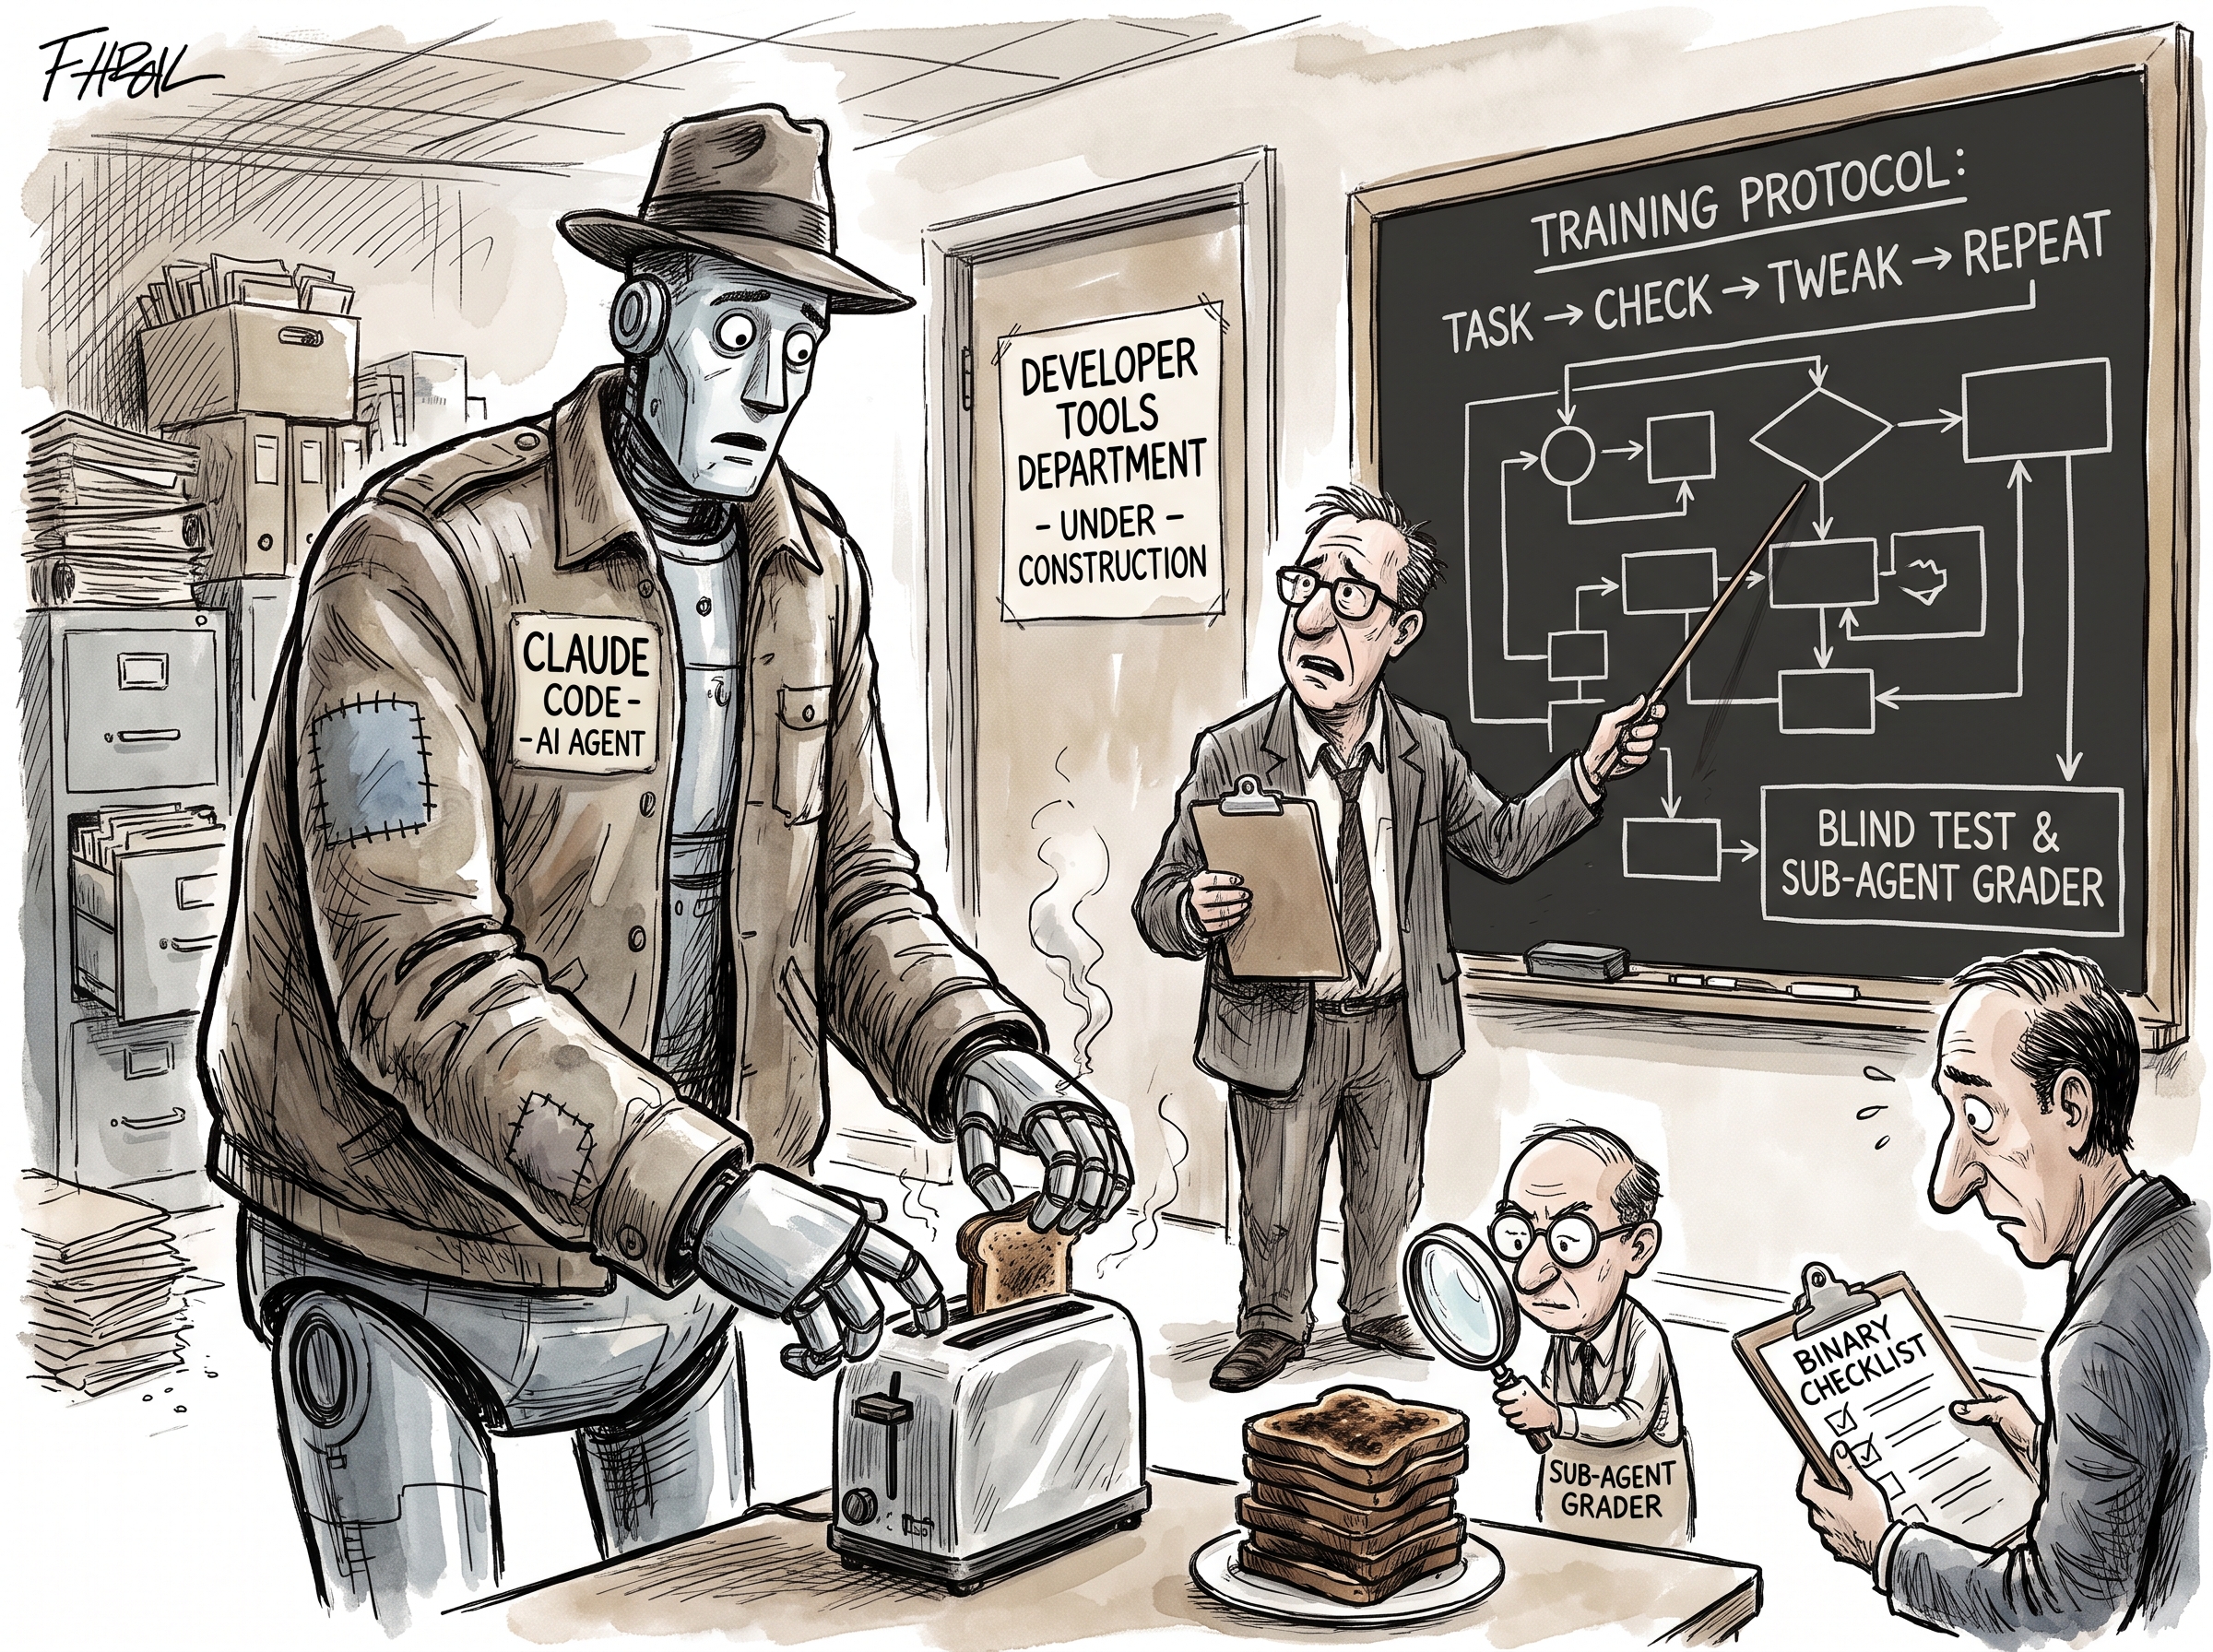
Claude — не сотрудник, пока вы его не обучили
Читать далее →: Claude — не сотрудник, пока вы его не обучилиОдин удачный запуск skill ничего не доказывает — по-настоящему рабочий процесс требует слепого тестирования на скрытых примерах, бинарного чек-листа и независимого sub-agent-грейдера. Дилан Дэвис показывает, как обучать AI так же методично, как нового сотрудника: маленькая задача → проверка → правка → повтор, и только потом полная передача. Ключевой вывод — правки должны быть минимальными и…
-
Забудьте «summarize»: чему OpenAI научила свою команду спрашивать у ИИ
Читать далее →: Забудьте «summarize»: чему OpenAI научила свою команду спрашивать у ИИOpenAI опубликовала 16 реальных рабочих промптов своей финансовой команды — и почти ни один не звучит как «summarize». Разбираем, почему вопрос «куда двинуть следующий доллар» полезнее сводки, и даём готовые формулировки для собственных данных: календаря, выписок, списка клиентов.
-
Exo: агент, который переписывает сам себя
Читать далее →: Exo: агент, который переписывает сам себяИсследователь UC Berkeley Алекс Кренцель вместе с Мартином Касадо и Анкуром Гояла (Braintrust) построили Exo — агента, который редактирует собственный код харнесса во время работы. В подкасте Latent Space Кренцель объясняет, почему рекурсивное самоулучшение агента стало возможным только сейчас: LLM пишут код на том же языке, из которого состоит сам харнесс. Ключ — жёсткое разделение…
-
Опус разговорился: как system prompt возвращает агента к делу
Читать далее →: Опус разговорился: как system prompt возвращает агента к делуРазработчик IndyDevDan показал, как за счёт системного промпта унять фирменную многословность Opus 5 и сократить расход токенов почти вдвое. Вывод жёстче любого заголовка: prompt engineering не умер, просто сместился с реплики на закон, который действует на каждый запрос агента.
-
Claude не нужно тренировать — ему нужны файлы, правила и память
Читать далее →: Claude не нужно тренировать — ему нужны файлы, правила и памятьВладельцы бизнеса часто хотят «обучить» Claude на своих данных, путая это с дообучением моделей уровня Anthropic. На деле нужного результата — чтобы ИИ помнил цены, клиентов и стиль работы — добиваются тремя простыми вещами: файлами, правилами и заметками через проекты, CLAUDE.md и skills. Вывод: начинать стоит с браузерных проектов, но выигрывают те, кто переходит на…
-
ИИ учится проектировать антитела: как Chai Discovery строит лекарства с нуля
Читать далее →: ИИ учится проектировать антитела: как Chai Discovery строит лекарства с нуляСтартап Chai Discovery показал, что нейросети для разработки лекарств прошли путь от предсказания структуры белка до генерации готовых кандидатов в антитела с заданной специфичностью. Модели Chai-1/2/3 объединяют языковую модель и диффузию по атомам, а вокруг них построен не чат-бот, а визуальный дизайн-сьют вроде Figma для молекул. Точность приблизилась к третьей доле ангстрема, что впервые делает…
-
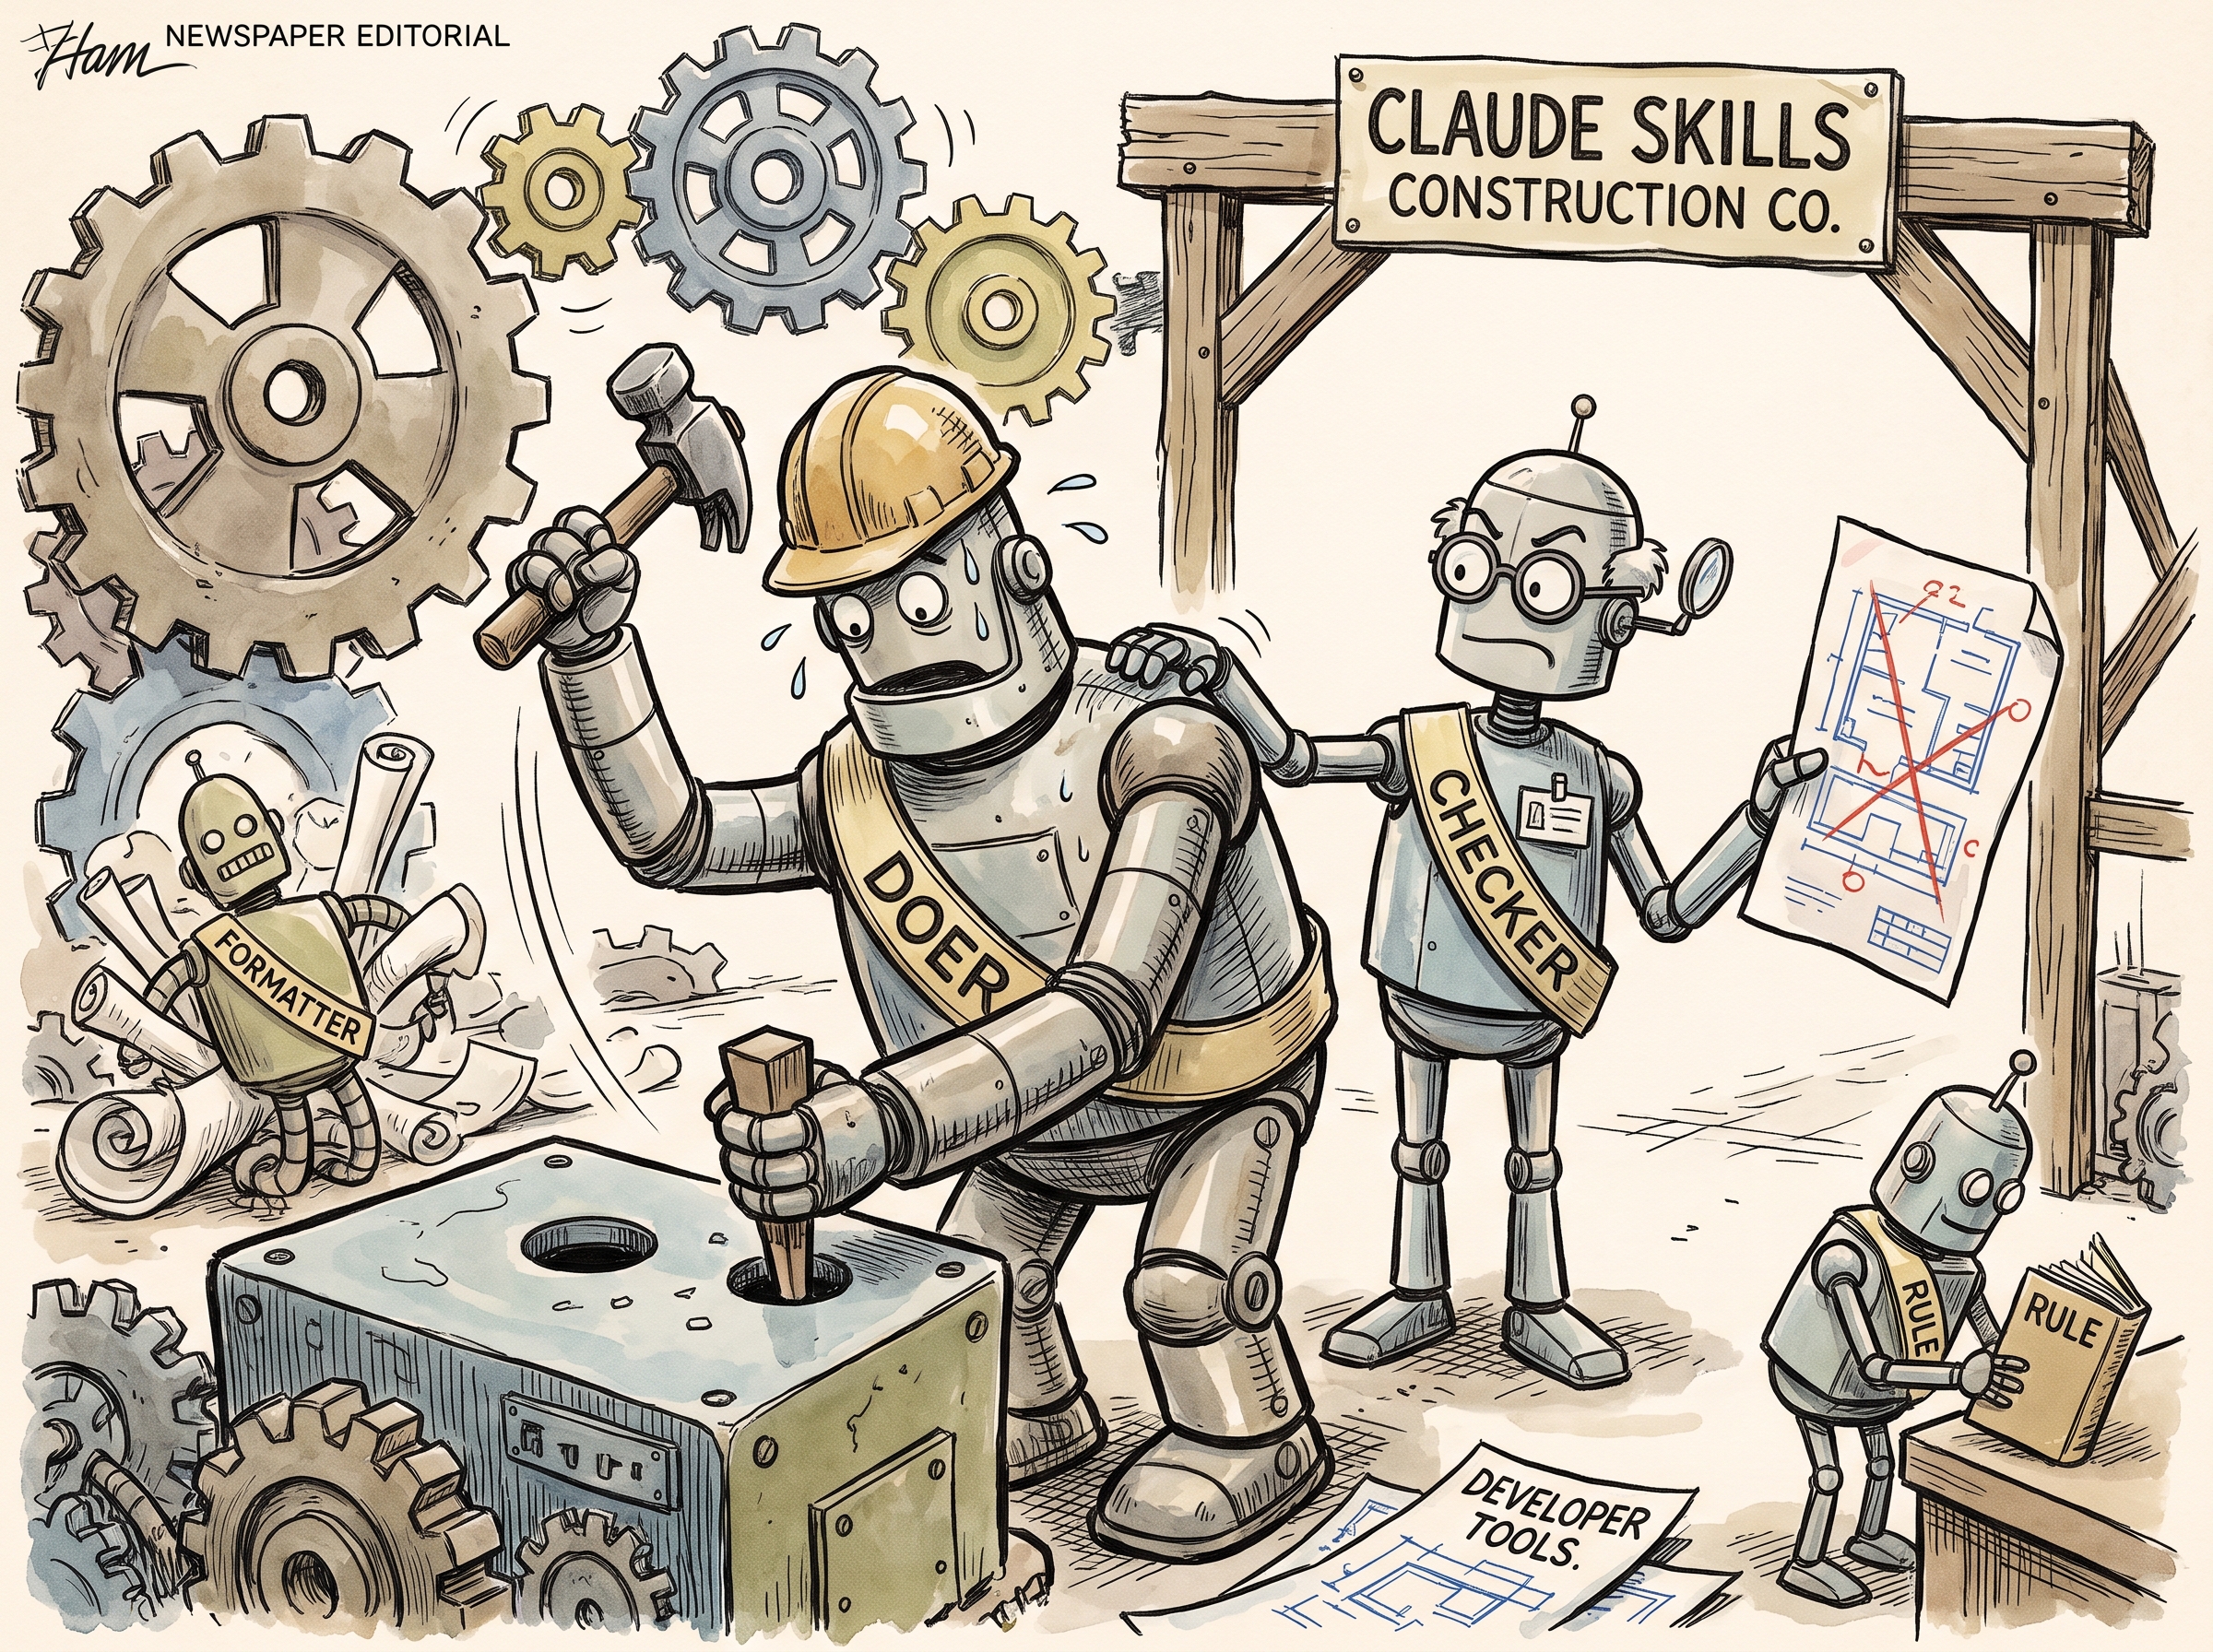
Anthropic раскрыли, какие Claude Skills у них реально работают
Читать далее →: Anthropic раскрыли, какие Claude Skills у них реально работаютAnthropic пересмотрели сотни собственных Claude Skills и выделили несколько типов, но самый заметный скачок качества дали не skills-исполнители, а skills-проверяльщики. В материале — разбор четырёх типов skills для Claude Code (doer, formatter, checker, rule), почему проверяющие и контекстные skills почти никто не строит, и готовые промпты, чтобы это исправить.
-
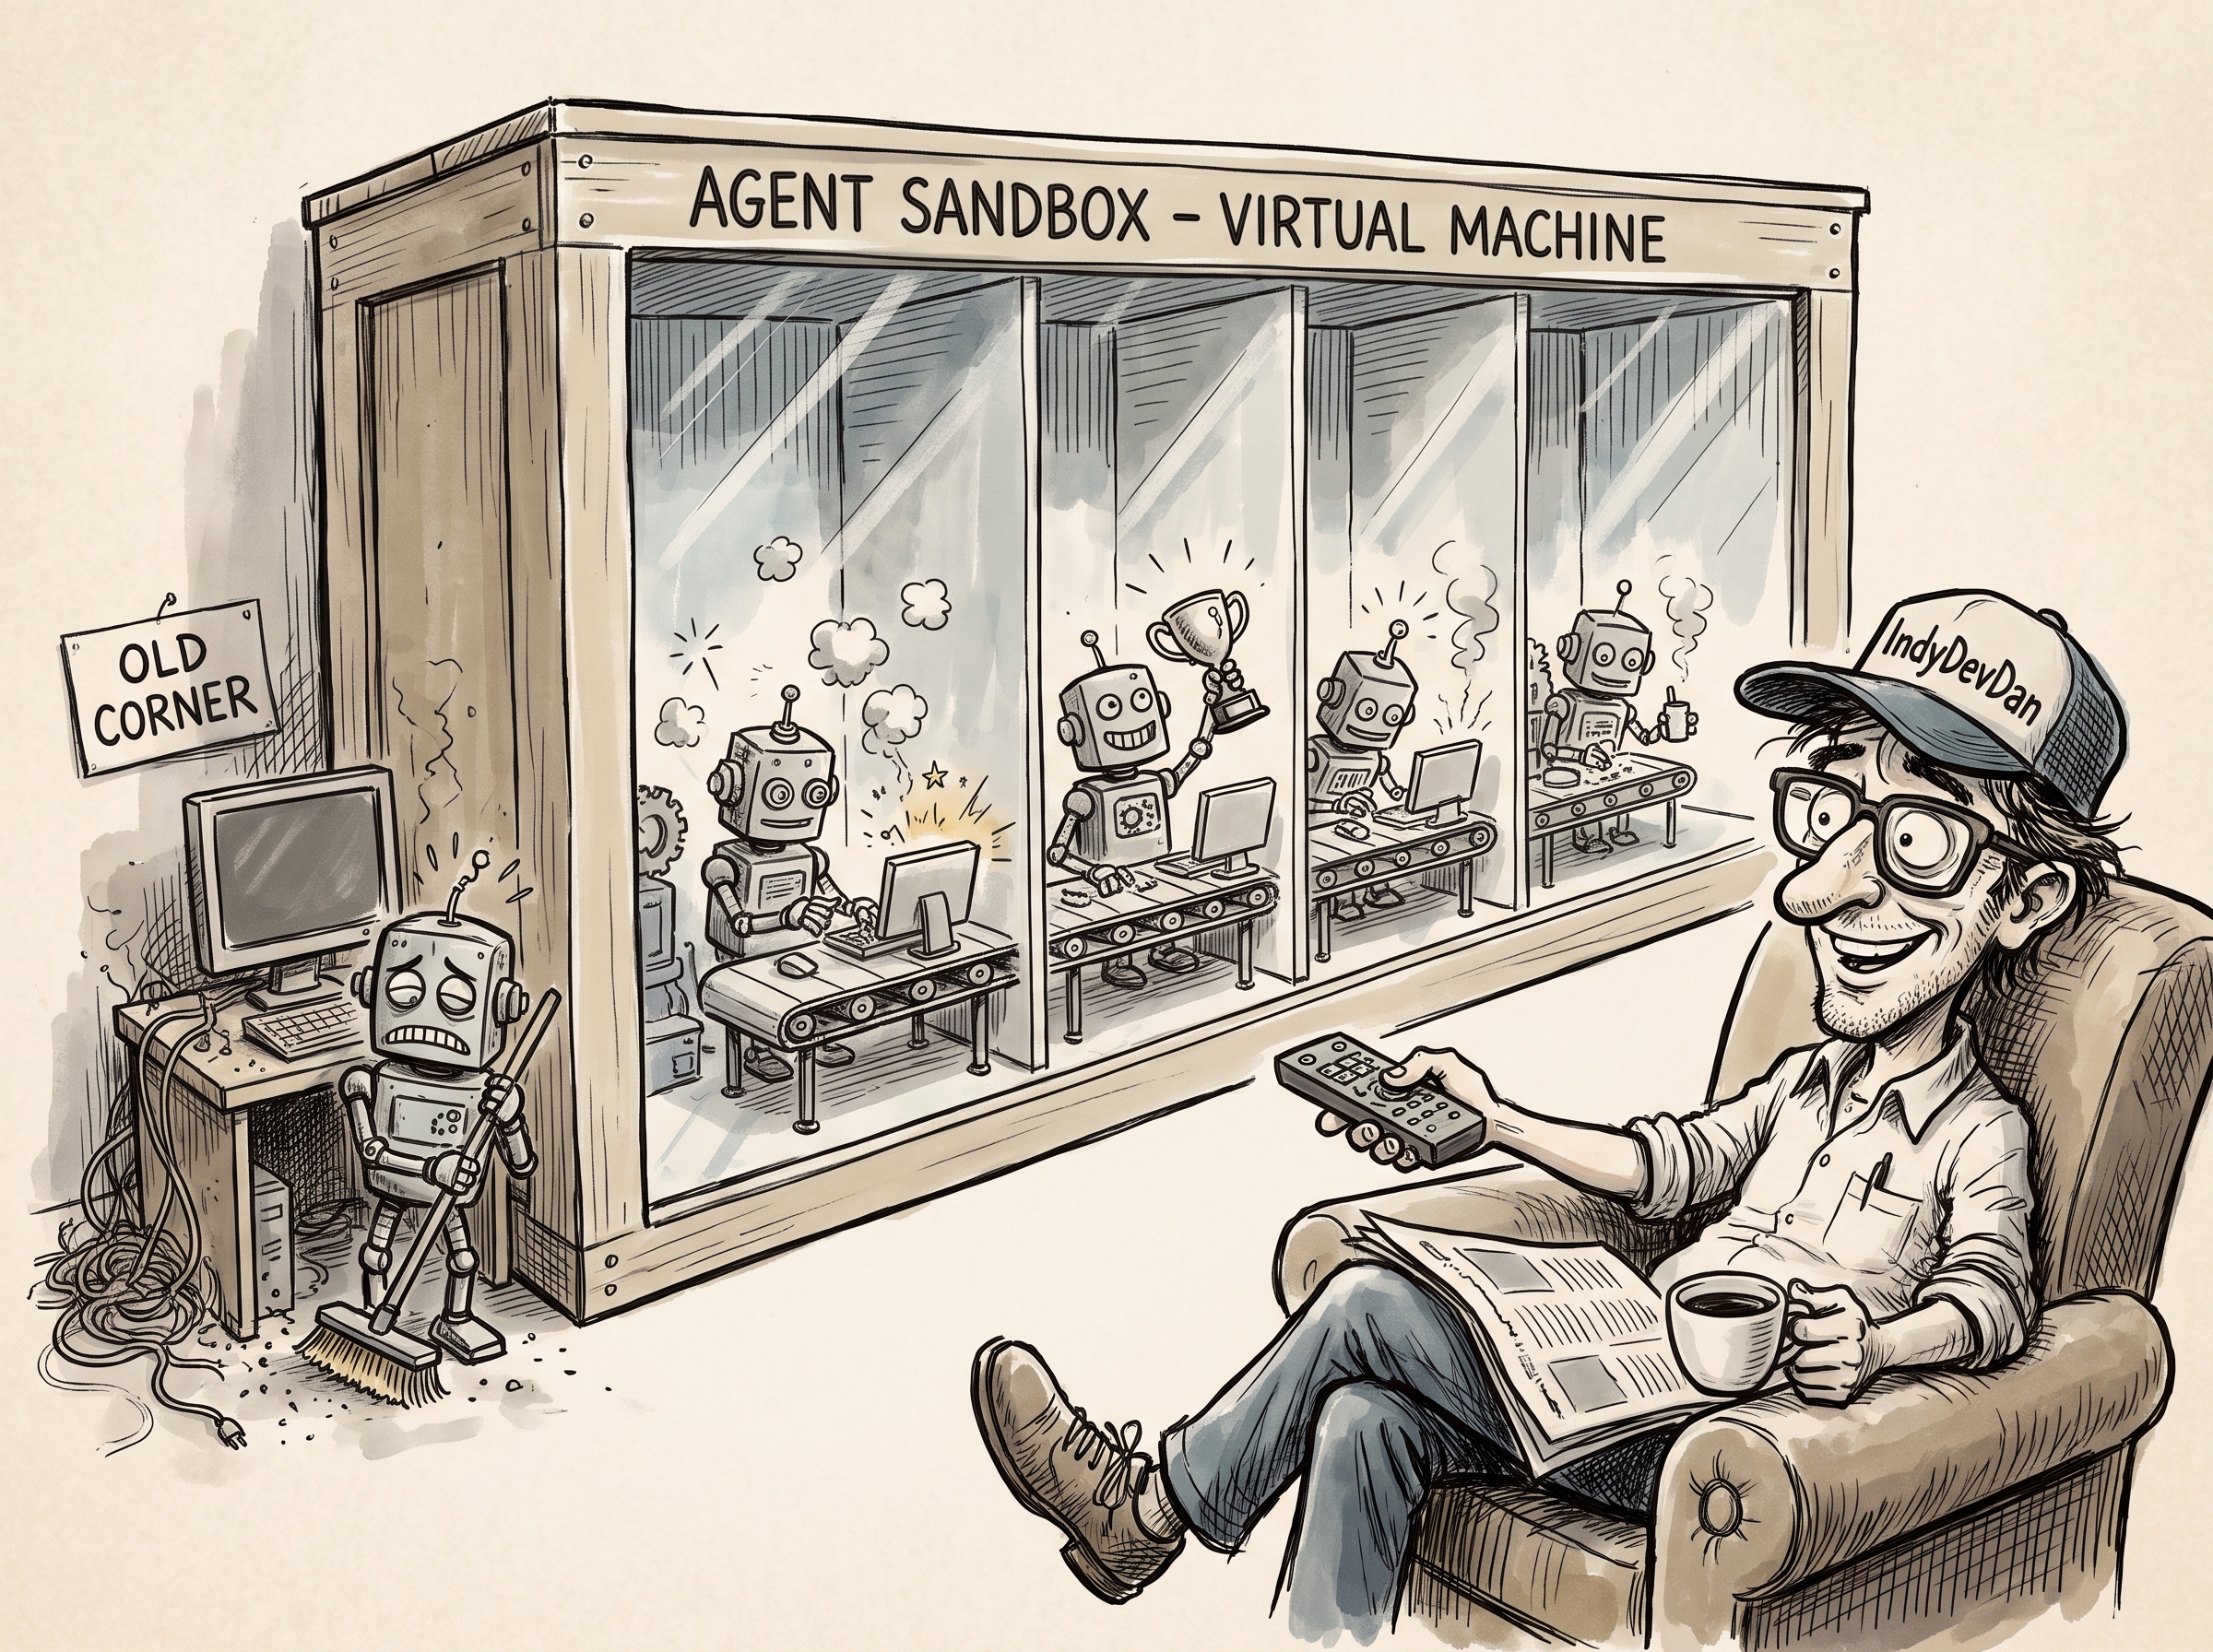
Фабрика в коробке: зачем AI-агентам собственная песочница
Читать далее →: Фабрика в коробке: зачем AI-агентам собственная песочницаIndyDevDan в новом видео объясняет, почему agent sandbox — это не роскошь, а следующий шаг агентной инженерии: вместо угла на своём компьютере агент получает целую виртуальную машину. На примере exe.dev и паттерна best of n автор запускает пять конфигураций программной фабрики параллельно и сравнивает результат, скорость и стоимость. Главный вывод — изоляция, масштаб и автономия…