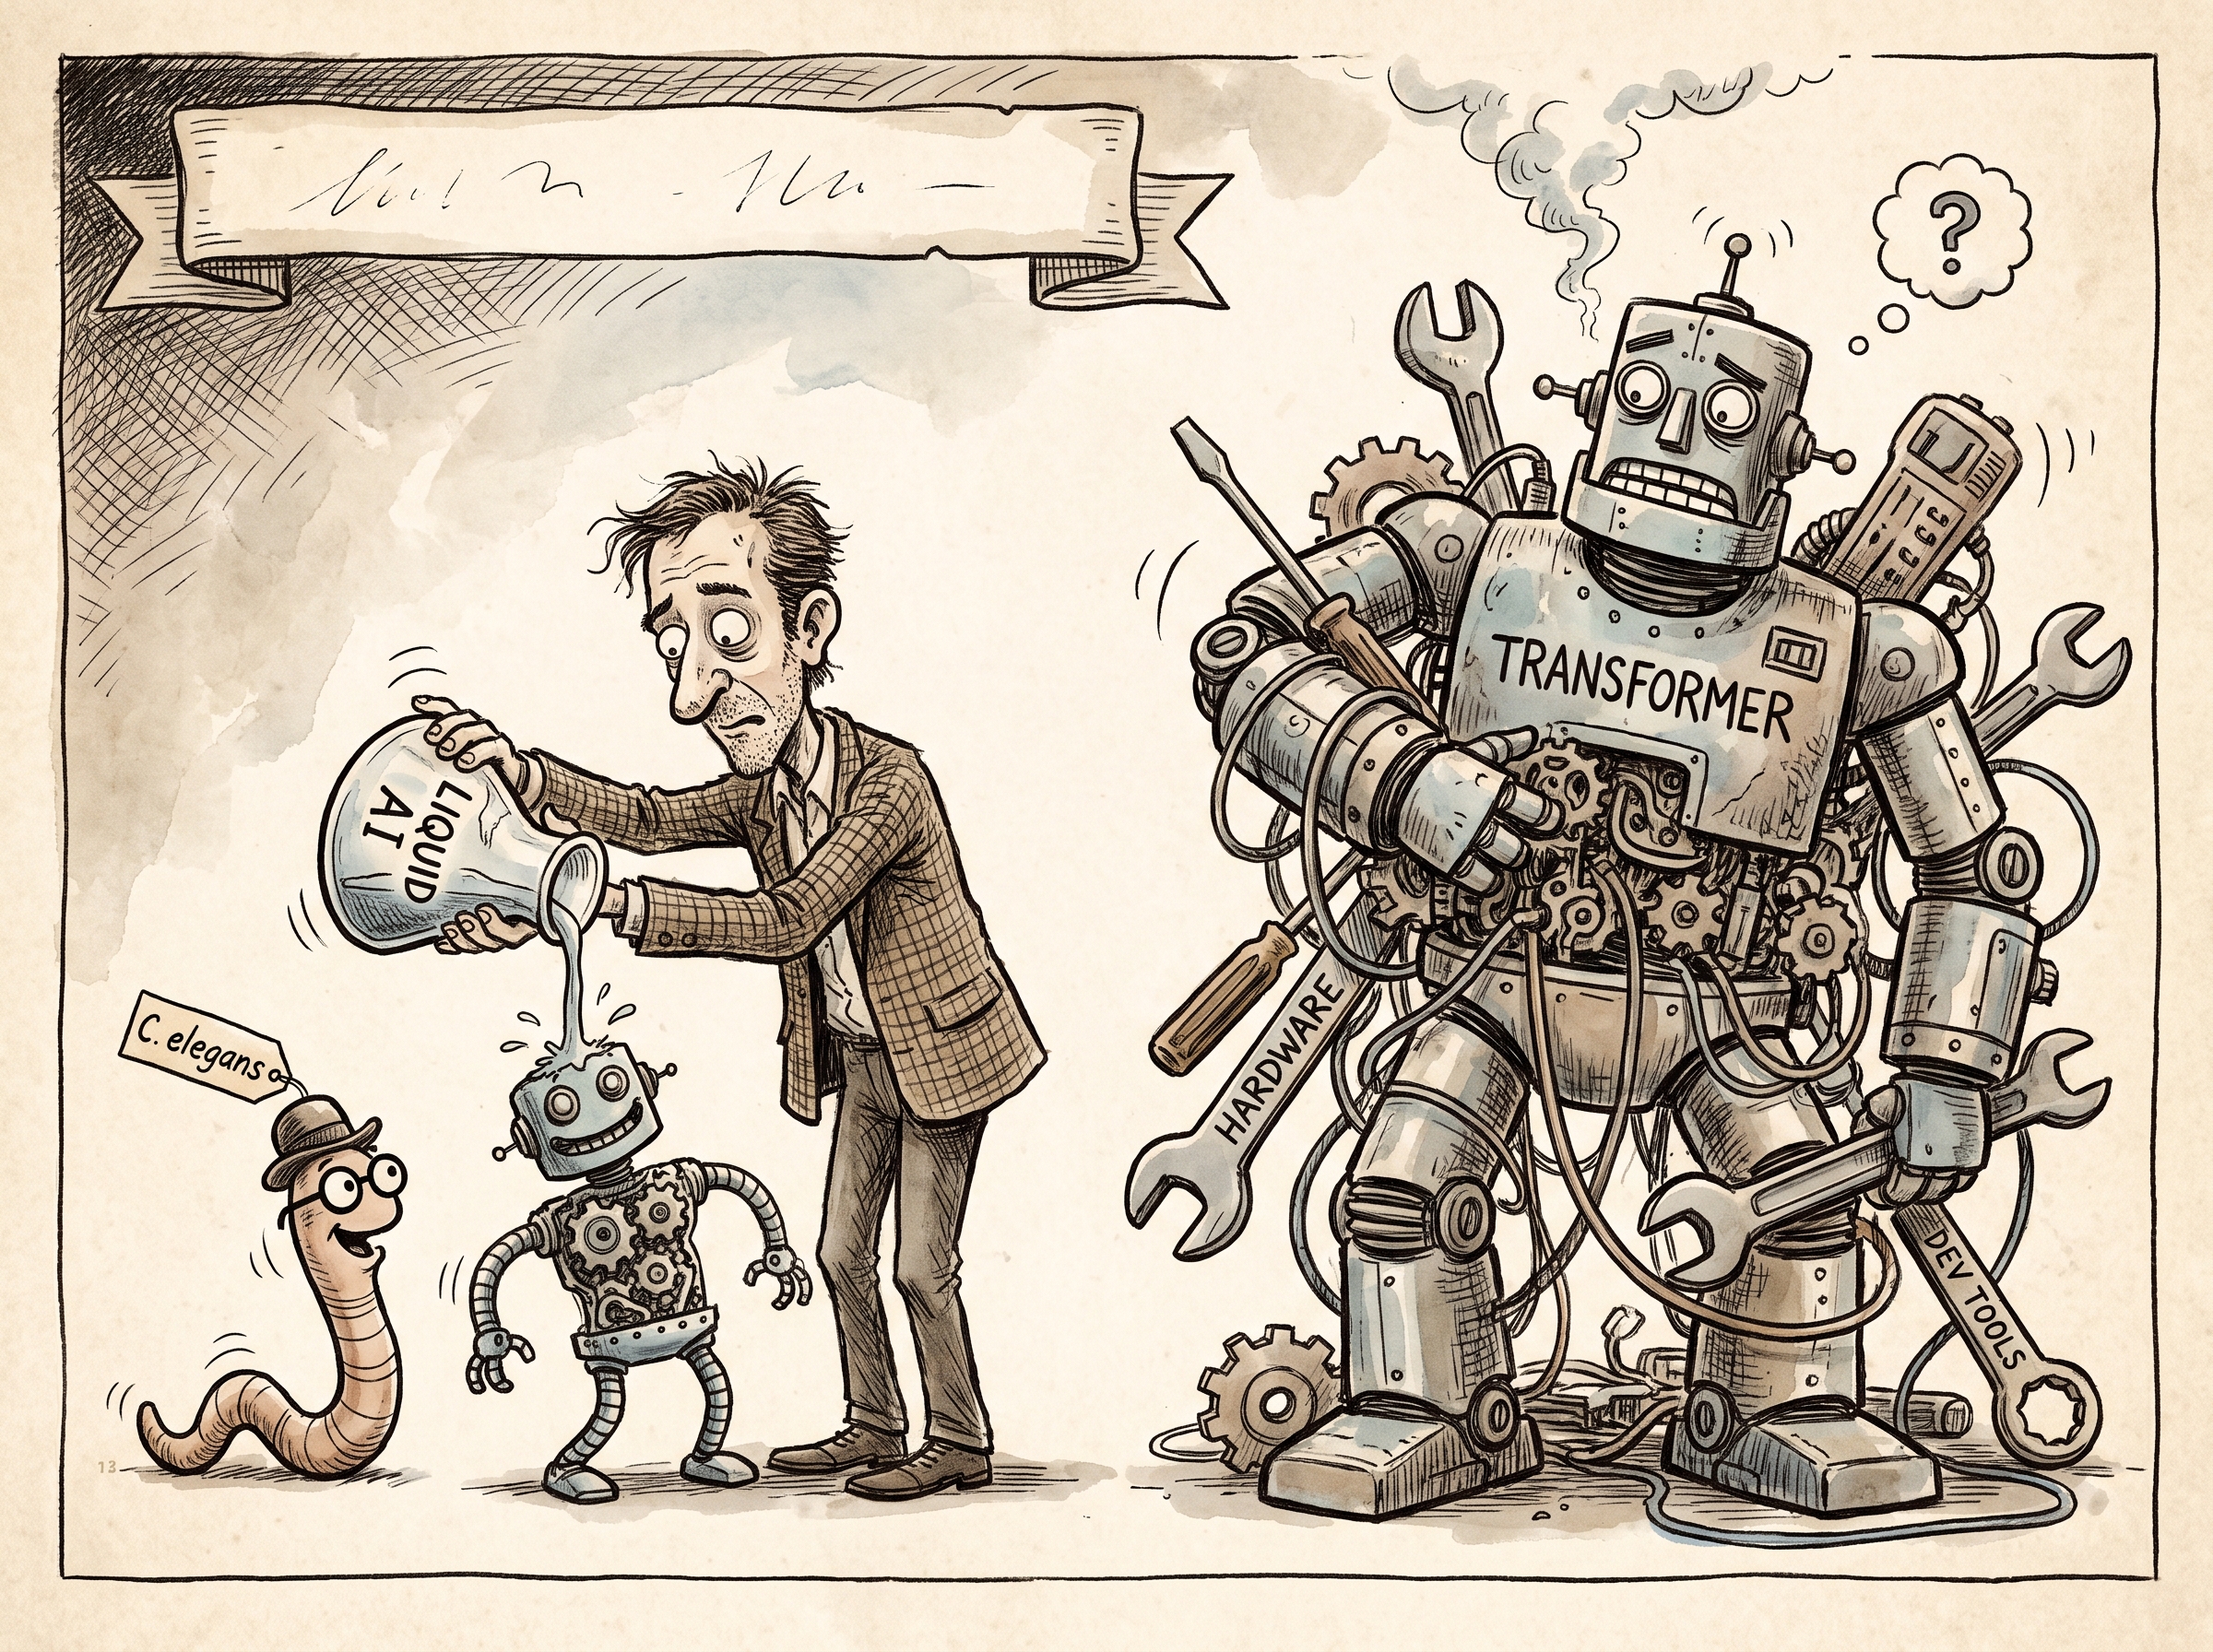
Когда в 2016 году исследователи из Венского технического университета решили поучиться у мозга, они выбрали не человека и даже не мышь, а круглого червя C. elegans — 2 миллиметра длиной, 302 нейрона на всё тело. Спустя почти десять лет эта затея превратилась в Liquid AI — компанию, чьи модели без единого трансформерного блока в основе управляют голосовым помощником в автомобилях Mercedes-Benz и обрабатывают больше миллиарда запросов в месяц в приложении Shopify. Основатель Liquid Рамин Хасани рассказал в подкасте Latent Space, как из нейробиологии червя выросла архитектура, конкурирующая с трансформерами не по силе, а по эффективности.
Жидкие нейронные сети: при чём тут червь
C. elegans — не случайный выбор. Его нейроны не «стреляют» импульсами, как у человека, а меняют состояние плавно, непрерывно — в неврологии это называют электротоническим поведением. Для машинного обучения это золото: такую динамику можно описать обычными дифференциальными уравнениями первого порядка и через них — обучать обратным распространением ошибки. Так родились liquid time-constant networks, жидкие нейронные сети: несколько десятков-сотен таких искусственных нейронов оказались способны решать задачи управления не хуже громоздких классических контроллеров робота. А тот факт, что 600 миллионов лет назад ветви эволюции человека и этого червя разошлись, а геном совпадает на 78%, придавал исследованию не только техническую, но и биологическую убедительность.
Ключевое отличие от трансформеров — рекуррентность вместо внимания. У attention-механизма стоимость вычислений растёт квадратично с длиной контекста; у рекуррентных систем — почти линейно. Проблема в другом: нелинейные рекуррентные вычисления плохо распараллеливаются на GPU, а линеаризованные версии (state space models) параллелятся легко, но теряют выразительность — им тяжело даются долгие зависимости в тексте.
От одной архитектуры к поиску архитектур
Вместо того чтобы поставить всё на одну схему, в Liquid AI собрали «авенджеров» — исследователей, стоявших за state space models, hyena, оригинальными liquid-сетями — и построили мета-систему, которая перебирает комбинации операторов (свёртки, внимание, рекуррентность) под конкретное железо и требования по задержке, памяти и качеству. Метод описан в статье STAR (synthetic tailored architecture) и по сути превратил дизайн модели в задачу поиска, а не ручного изобретательства.
Результат — семейство Liquid Foundation Models. Первая версия была «смесью всего», вторая (LFM2) уже осознанно оптимизирована под CPU: около 80% архитектуры — это 1D-свёртки с гейтами, и лишь пятая часть — классическое group query attention. По словам Хасани, чем крупнее модель, тем меньше в архитектуре должно быть структурных «предубеждений» — сложные петли обратной связи нужны только в маленьких моделях с жёстким лимитом памяти, а на масштабе выигрывает простота.
ИИ без облака: где это уже работает
Главный тезис Liquid — не «наша архитектура лучше», а «интеллект должен уметь жить вне дата-центра». Компания поставляет модели весом в сотни мегабайт, которые можно обновлять по воздуху (OTA) прямо в автомобиле: с этого года голосовой ассистент на базе Liquid поедет во всех Mercedes-Benz поколения 3 в Северной Америке, работая на чипе стоимостью около 100 долларов. С AMD компания встраивает модели в ИИ-ПК, с промышленными робототехническими стартапами — в компьютерное зрение для заводских линий. У Shopify модели Liquid отвечают на запросы в приложении Shop — счёт идёт на миллиарды обращений в месяц, и там важна не эрудиция модели, а задержка ответа.
Логика проста: облачный инференс на сотни миллионов устройств — это прямые издержки, которые растут вместе с базой пользователей. Локальная модель убирает эту статью расходов и даёт офлайн-режим, приватность (данные не покидают устройство) и возможность фильтровать чувствительную информацию до того, как она уйдёт в облачного агента вроде Claude Code.
Что дальше: кастомизация вместо инференс-токенов
Хасани формулирует следующую волну рынка иначе, чем принято: сегодня 90% денег в индустрии — это токены инференса у фронтир-лабов. Но зрелые предприятия (Liquid работает примерно с 200 компаниями из Fortune 500) устали строить собственные ML-команды и хотят просто владеть своей моделью — от предобучения до дообучения под конкретные данные. Поэтому Liquid выводит self-serve платформу, которая подключается прямо к агентному харнессу разработчика и проводит его через весь цикл: от архитектурного поиска до готового к деплою GGUF-бандла.
Вывод
История Liquid AI — хороший аргумент против архитектурного догматизма. Компания не пытается доказать, что жидкие нейронные сети победят трансформер везде и всегда; она показывает, что вопрос «какая архитектура лучше» вообще неправильно поставлен, если не привязан к железу, бюджету по памяти и задаче. Для разработчиков и продуктовых команд, которым тесно в облачном API, это сигнал: следующий год конкуренции в ИИ будет не только про параметры и бенчмарки, а про то, кто научится упаковывать интеллект в 600 мегабайт и заставит его работать офлайн.
Latent Space — подкаст для AI-инженеров. Источник: видео «A Worm With 302 Neurons Inspired Their Architecture — Ramin Hasani, Liquid AI».
Добавить комментарий