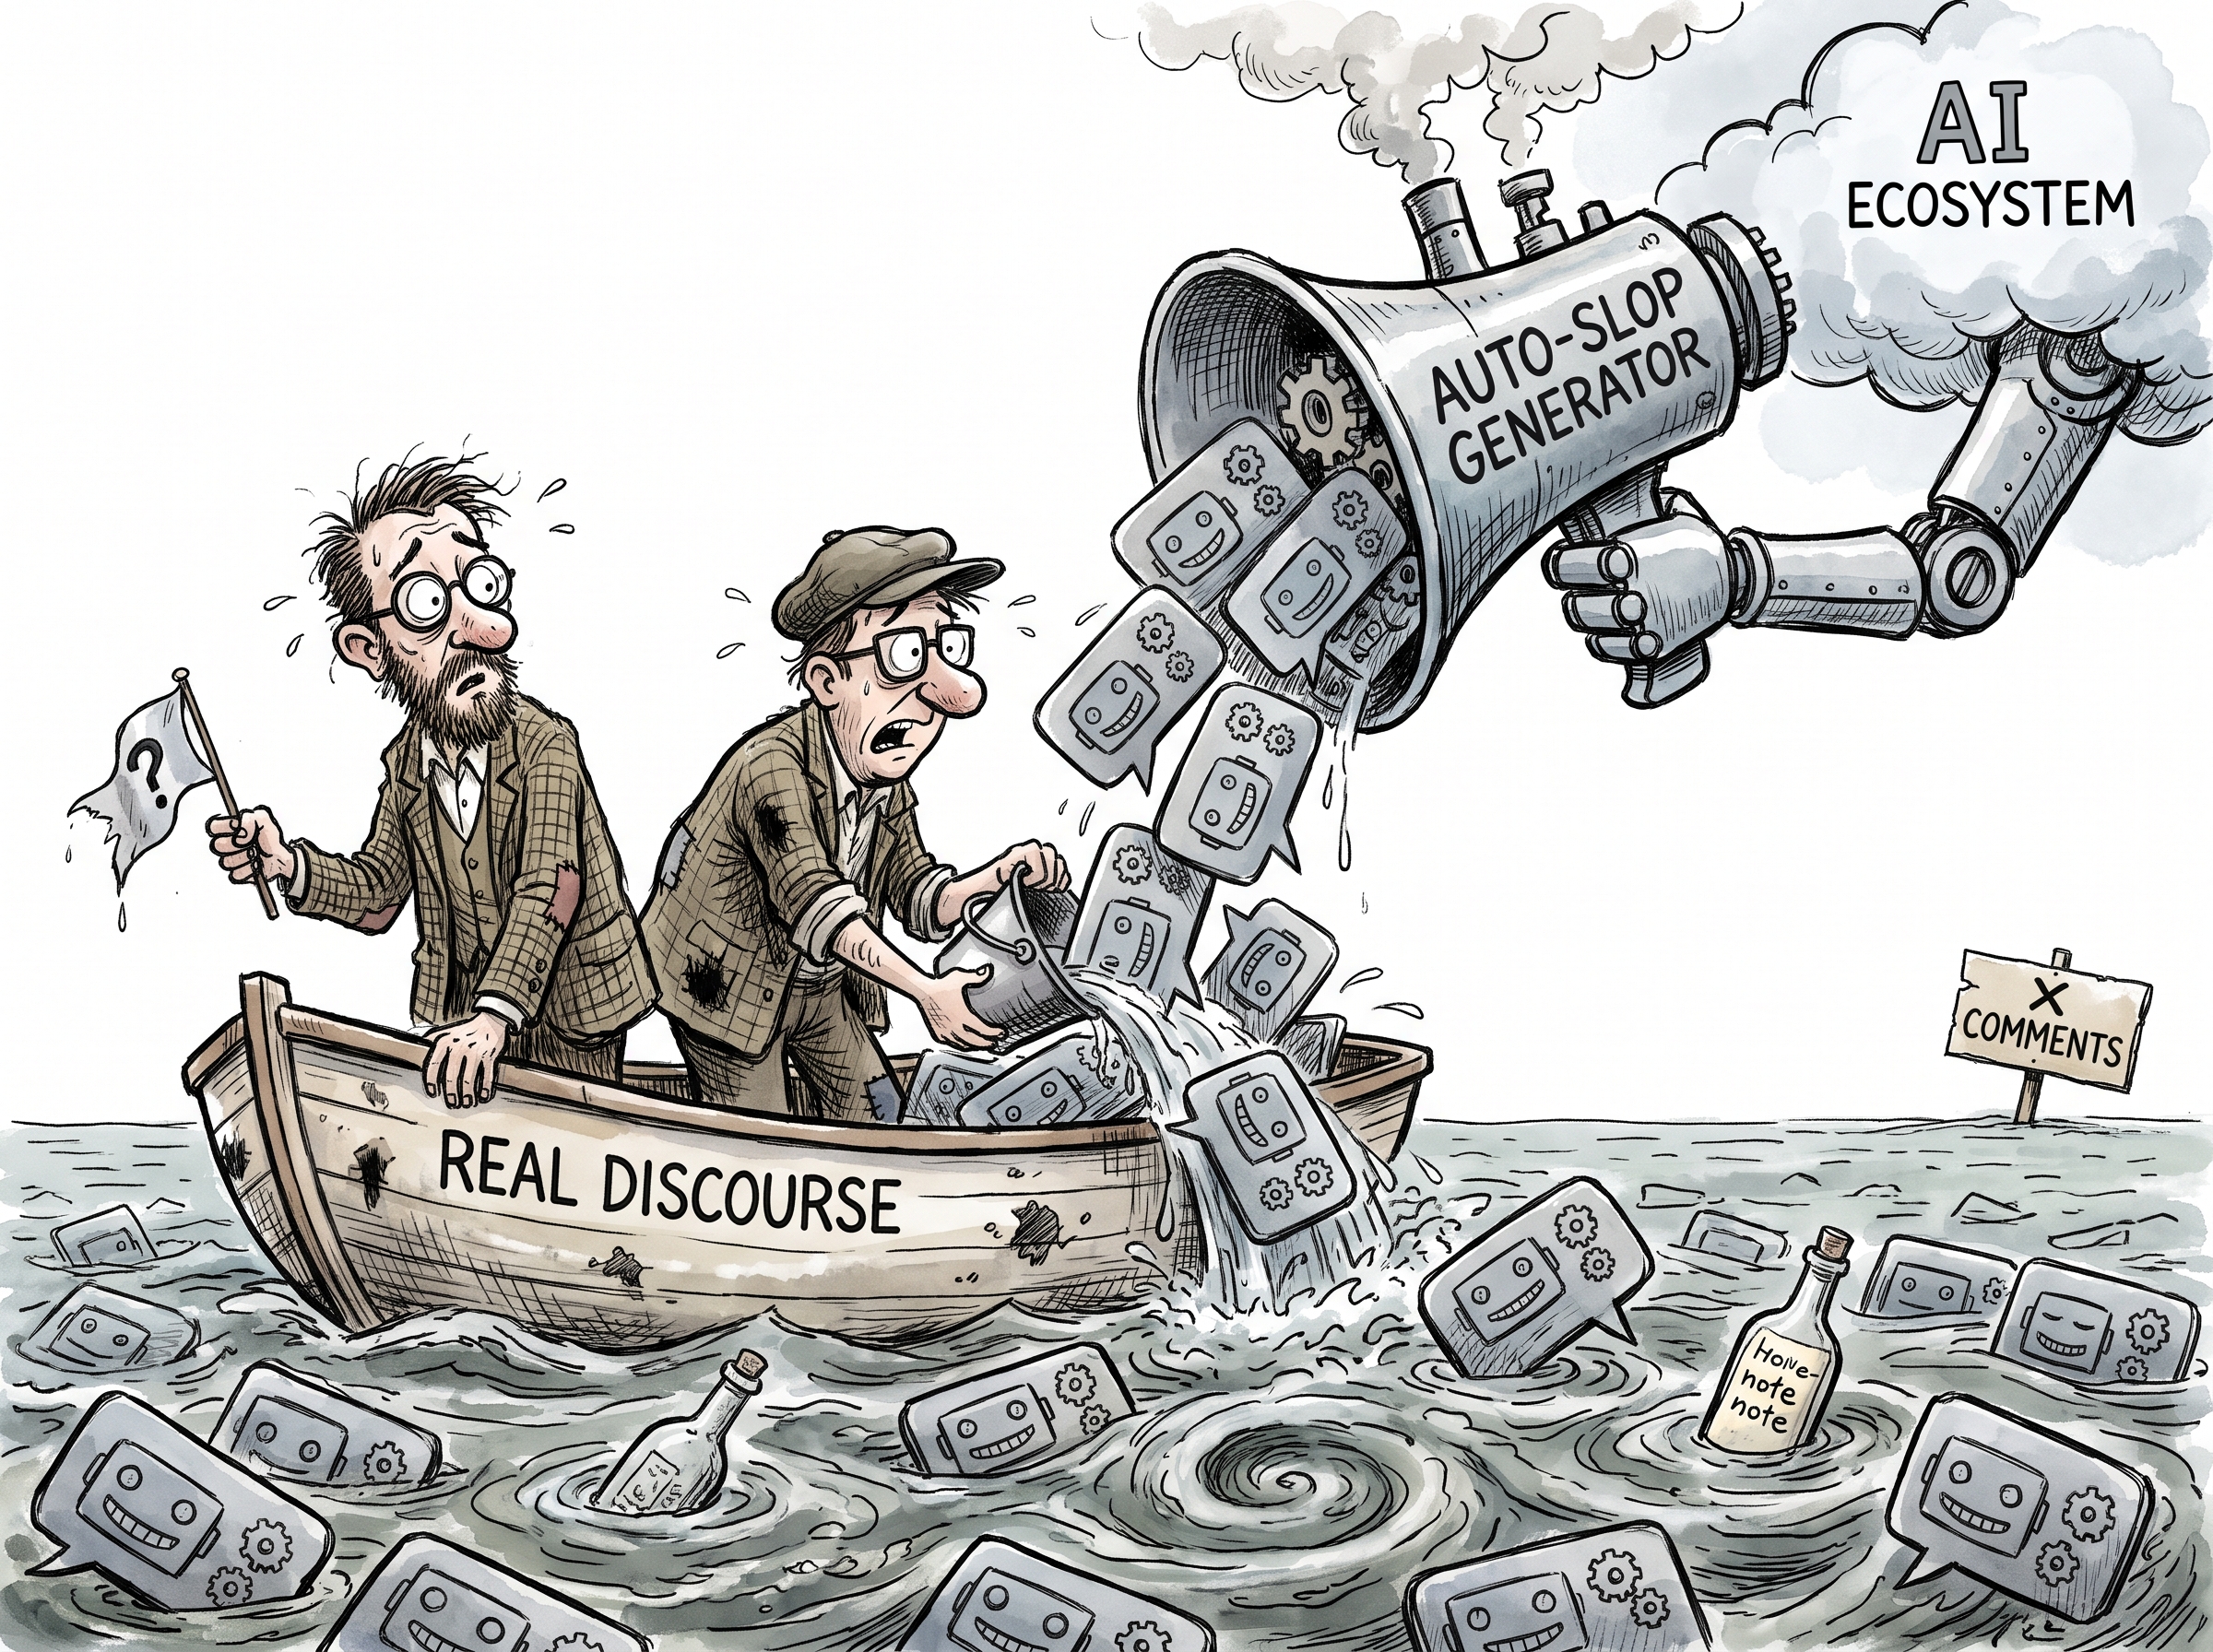
Два твита одного дня от Симона Уиллисона — и разительный контраст между ними говорит больше, чем кажется на первый взгляд. Один — усталая жалоба на то, во что превратились комментарии в X. Другой — восторженное открытие, что в «Кто подставил кролика Роджера» на секунду мелькает пеликан на велосипеде. Первое — симптом болезни, второе — лекарство от неё. Речь о явлении, которое всё чаще называют LLM slop: потоке автогенерированных, бессодержательных ответов, заполонивших соцсети.
Что такое LLM slop и почему он бесит именно сейчас
Ретвит, который сделал Уиллисон, принадлежит Армину Ронахеру (mitsuhiko), создателю Flask и человеку, хорошо знакомому с тем, как работают языковые модели изнутри. Его жалоба короткая и злая: он практически перестал отвечать на комментарии под собственными твитами, потому что заранее уверен — это LLM slop. Не спам в привычном смысле, не боты с рекламой, а вежливые, грамматически безупречные, абсолютно пустые реплики, сгенерированные моделью специально под пост.
Проблема не в том, что ИИ умеет писать такие ответы — умел он это и год назад. Проблема в масштабе: генерация стала настолько дешёвой и доступной, что превратилась в фон, шум, который забивает канал связи между автором и живым читателем. Когда цена комментария падает до нуля, падает и его ценность — а вместе с ней и желание автора вообще заглядывать в раздел ответов.
Кому это важно: авторам, платформам и разработчикам ИИ-инструментов
Для авторов вроде Уиллисона и Ронахера это прямой удар по мотивации писать публично — соцсети существуют ради обратной связи, и если обратная связь превращается в LLM slop, смысл площадки размывается. Для платформ это репутационный риск: X и подобные сервисы держатся на ощущении живого разговора, а не на витрине сгенерированной вежливости.
А что с сообществом Claude Code?
Для тех, кто строит и использует ИИ-инструменты — включая Claude Code и агентов на его основе — история звучит как предупреждение, а не повод для злорадства. Разница между полезной автоматизацией и LLM slop не в технологии, а в задаче: одно дело — агент, который пишет код, тестирует и решает конкретную проблему, другое — модель, штампующая социальный шум под видом участия в разговоре. Граница проходит по критерию «делает ли это что-то реальное», и разработчикам инструментов стоит держать её в голове при каждом новом сценарии применения агентов.
Как отличить живой комментарий от LLM slop
Несколько практических признаков, которые уже выделяет сообщество: генеральная похвала без конкретики («отличная мысль!»), отсутствие ссылки на деталь из самого твита, ровный «причёсанный» тон независимо от темы, и синхронное появление похожих по структуре ответов от разных аккаунтов. Ни один признак не доказателен сам по себе, но их сочетание — довод в пользу того самого раздражения, которое выразил Ронахер.
Пеликан на велосипеде как противоядие
Второй твит Уиллисона — почти случайная деталь из старого фильма — работает как контрапункт не по случайности. Живое человеческое любопытство, которое замечает нелепого пеликана на велосипеде в мультфильме 1988 года, нельзя сгенерировать по запросу «напиши интересный факт о кино». Это конкретное, личное, немного странное наблюдение — то есть ровно то, чего лишён LLM slop.
Вывод
Жалоба на LLM slop — не брюзжание разработчиков старой школы, а раннее предупреждение о том, куда ведёт бесконтрольное применение генеративных моделей в социальном взаимодействии. Для тех, кто делает ИИ-инструменты всерьёз, урок простой: ценность агента измеряется тем, решает ли он задачу, а не тем, как гладко он умеет притворяться собеседником.
Добавить комментарий