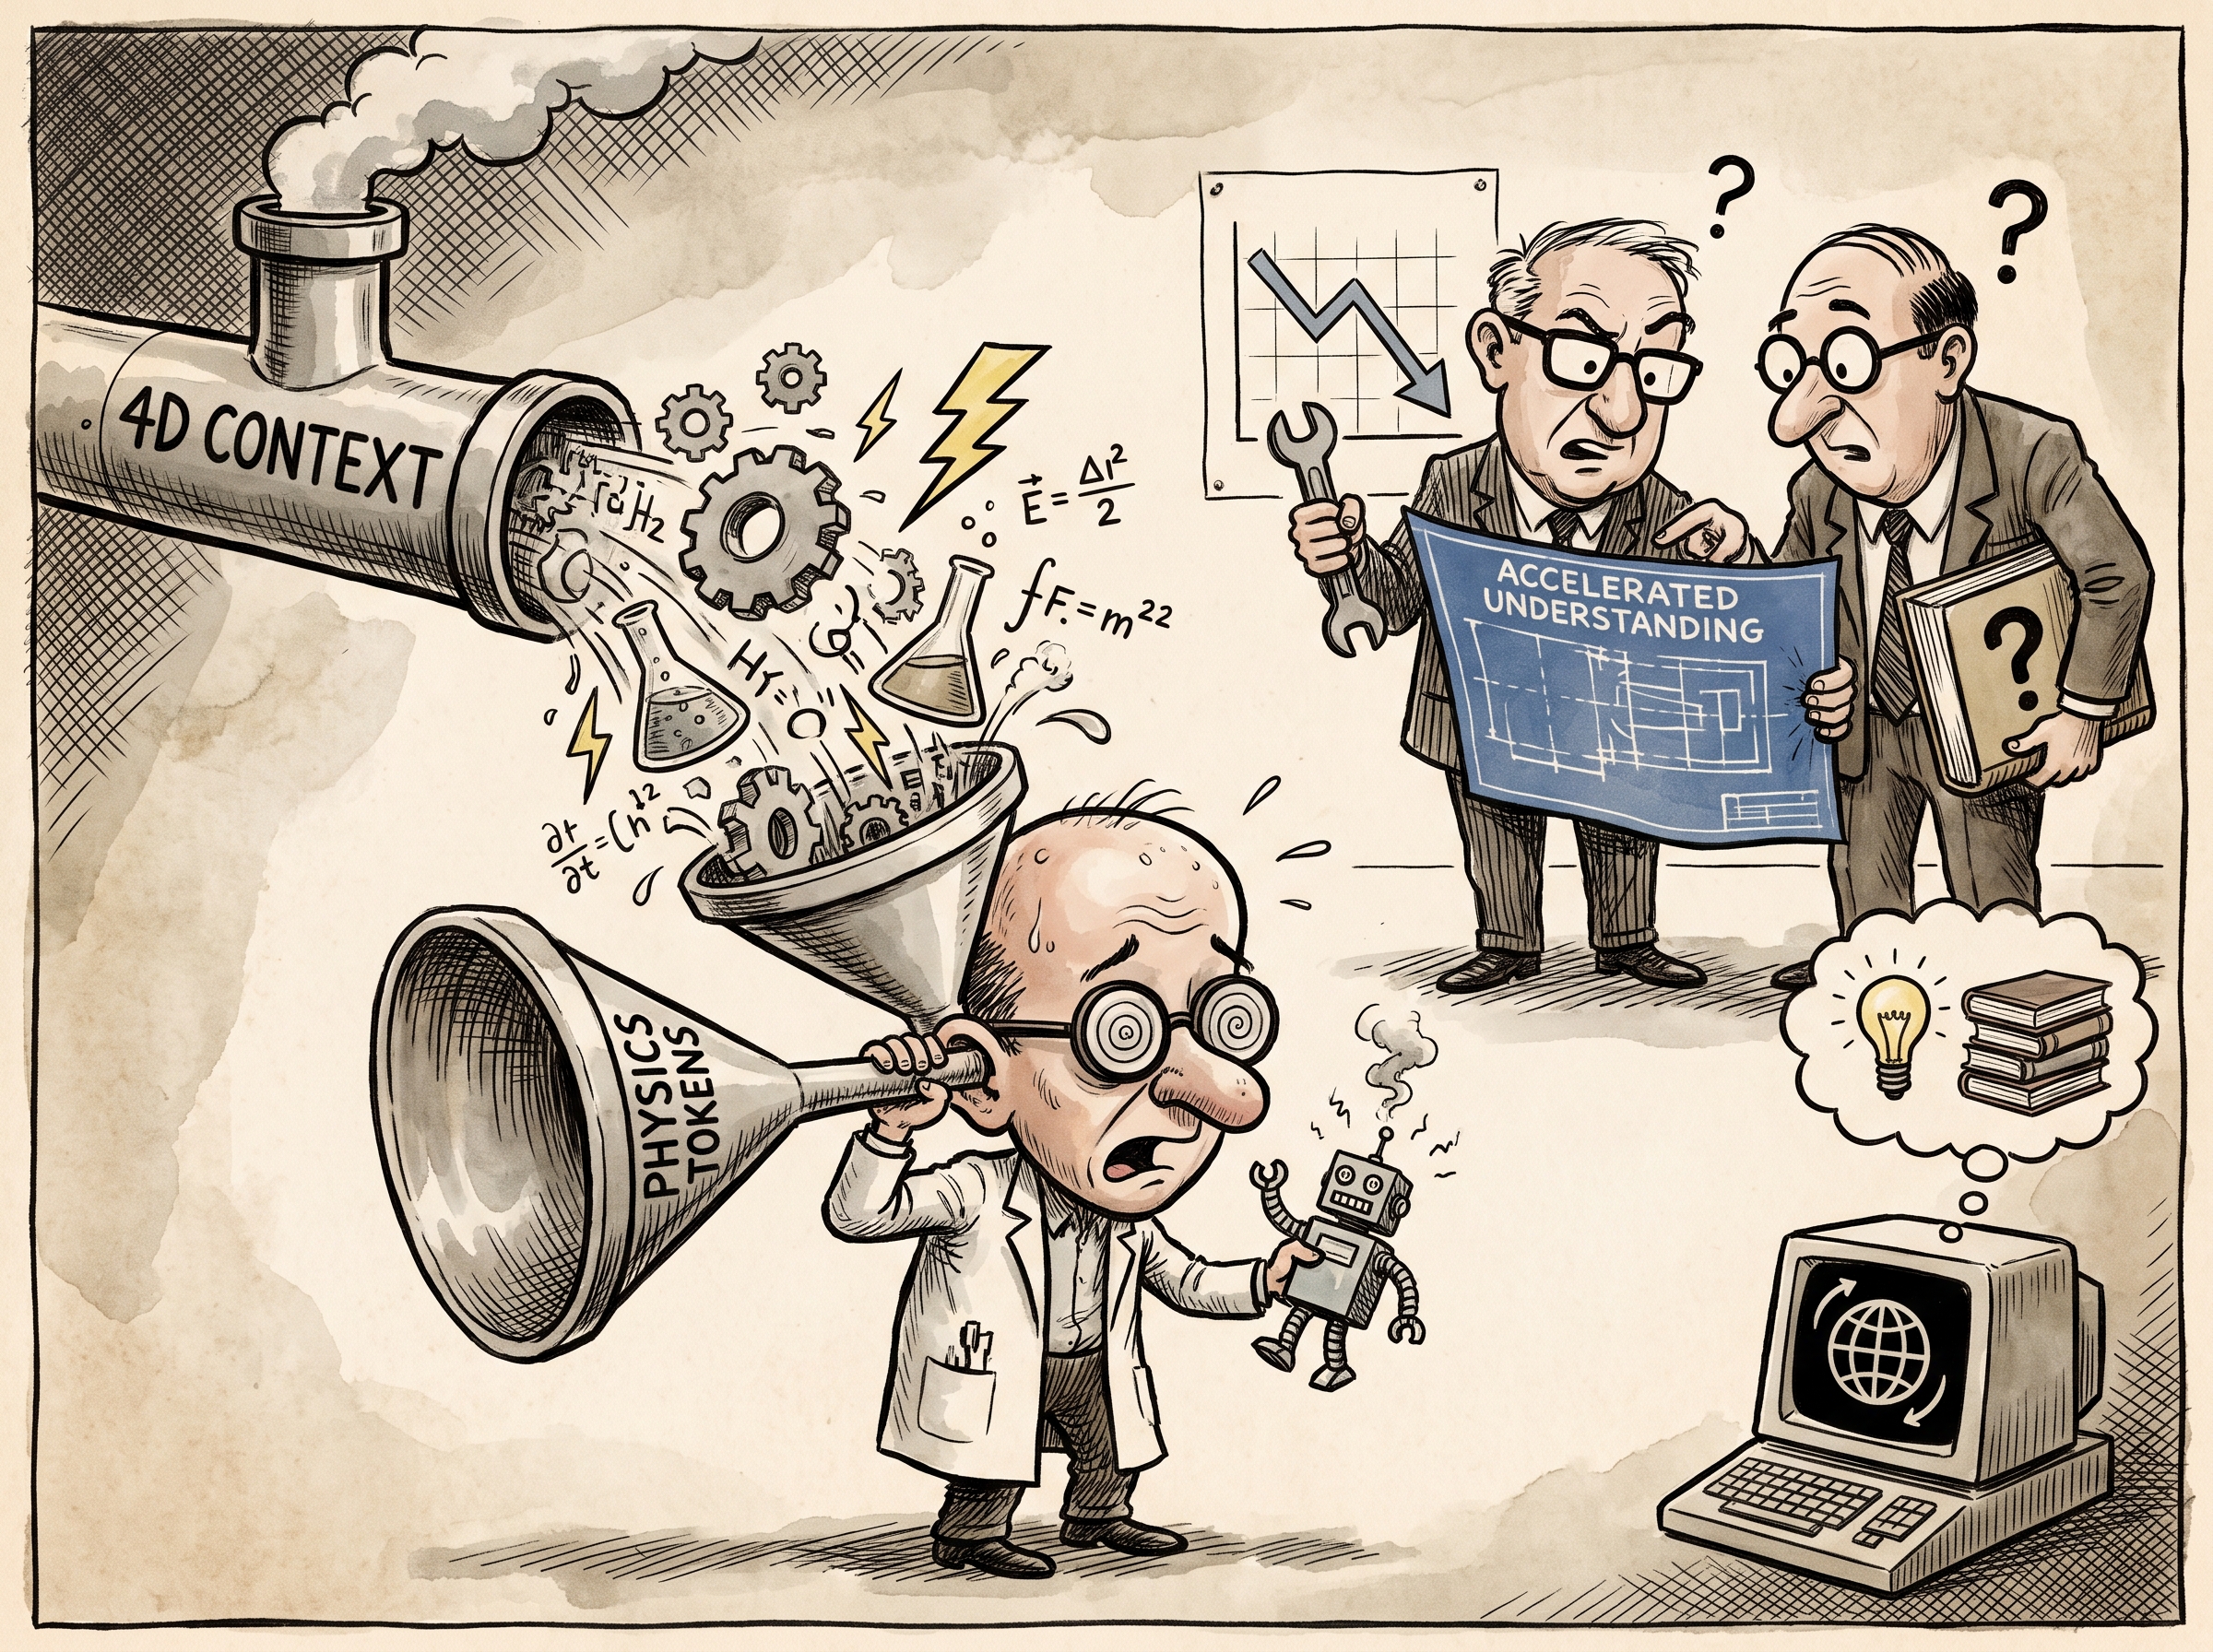
Языковые модели выиграли от одной простой ставки: свалить весь текст интернета в одну модель — и она сама разберётся лучше специализированных систем проверки орфографии или перевода. Anima Anandkumar и Benedikt Jenik из стартапа Accelerated Understanding задались вопросом, работает ли та же ставка для физического мира. Ответ, который они показали в подкасте Latent Space, — да, но с существенной оговоркой: нейросети для симуляции физики нельзя строить так же, как языковые модели, потому что данных о реальном физическом мире просто нет в открытом доступе в нужном объёме.
От языка к физике: тот же масштаб, другая ловушка
У GPT-подобных моделей был готовый датасет — весь текст сети. У погоды, ядерного синтеза, катетеров и полупроводников такого корпуса нет: научные открытия по определению описывают то, чего ещё нет в обучающей выборке. Поэтому чистое масштабирование данных здесь бессмысленно. Команда Accelerated Understanding решает это иначе: вместо того чтобы ждать данных, они встраивают в модель сами законы физики — дифференциальные уравнения в частных производных (PDE), общие для гидродинамики, ракетных двигателей и распространения тепла в чипе, несмотря на то, что предметные области выглядят совершенно разными.
Нейронные операторы вместо трансформеров
Архитектурная основа — развитие идеи neural operators (в частности, Fourier Neural Operator), которую Anandkumar разрабатывала ещё в академии. Их принципиальное отличие от видео- или vision-трансформеров, лежащих в основе большинства «world models»: neural operators инвариантны к разрешению. Обучившись на грубой сетке, модель применима и на детальной, и наоборот — можно гонять дешёвые расчёты там, где не нужна точность (игры, ранний research), и подключать дорогое разрешение только там, где оно критично (инженерный дизайн, научные открытия). Трансформерная архитектура с квадратичной сложностью внимания для этого просто непрактична: физический мир не описывается произвольными корреляциями «всё со всем», в нём есть встроенная структура, и архитектура должна её отражать.
Триллионный контекст без интернет-масштаба данных
Заявленный «контекст в триллионы токенов» — не про текстовые токены, а про естественный рост размерности: три пространственных измерения плюс время перемножаются в объёме, эквивалентном триллионам входных и выходных значений (в одном из прогонов — 5 триллионов, а вывод одного расчёта занял 22 терабайта). Это потребовало не масштабирования существующей инфраструктуры, а её пересборки с нуля: стандартный FSDP-шардинг рассчитан на то, что слой можно переразмещать между GPU, а здесь одного узла не хватает даже под один образец данных.
Мультифизика как аналог переноса знаний в LLM
Самый неочевидный результат — модель, обученная сразу на множестве физических доменов (полупроводники, энергетика, аэрокосмос), показывает себя лучше узких моделей, обученных под одну задачу, даже когда те увеличивают в размерах. Это прямой аналог emergent-переноса знаний между языками и темами у языковых моделей: общие для разных уравнений закономерности (сохранение энергии, причинность, зависимость от времени) дают модели «плотную» обратную связь — в отличие от LLM, где RLHF даёт лишь редкий сигнал «нравится / не нравится». Из уравнений можно синтетически генерировать сколько угодно обучающих данных и выстраивать curriculum: от простых решений к грубым солверам, затем — к тонким деталям через численную симуляцию.
Кому это уже пригодится
Из стелса компания вышла не с чистой наукой, а с коммерческими клиентами в полупроводниковой и энергетической отраслях: тепловой шум, электромагнитные наводки и совместное цифро-аналоговое проектирование чипов — задачи, где точный физический расчёт традиционно стоил TSMC огромных вычислительных бюджетов. Та же архитектура нацелена и на термоядерный синтез, и на геотермальную энергетику — области, где раньше приходилось идти на грубые упрощения именно из-за нехватки вычислений, а не понимания физики.
Почему это важно
Главный вывод не в рекордном числе токенов, а в демонстрации: там, где у языковых моделей был бесплатный интернет-датасет, у физики есть кое-что не менее ценное — сами законы природы, которые можно встроить в архитектуру и использовать как источник почти неограниченных данных для самообучения. Если этот подход подтвердится на действительно тяжёлых задачах вроде синтеза, граница между «дешёвым ИИ-приближением» и «дорогим точным расчётом» в инженерии и науке начнёт стремительно сдвигаться.
Latent Space — подкаст для AI-инженеров. Источник: видео «Trillion Token Context. No, Really — Anima Anandkumar & Benedikt Jenik, Accelerated Understanding».
Добавить комментарий